VLA 모델 계보: RT-2에서 π0.6, GR00T, Gemini Robotics까지
"로봇 행동을 또 하나의 언어로 표현한다. 그러면 행동은 텍스트 토큰이 되고, 인터넷 규모의 비전-언어 데이터와 함께 학습할 수 있다." — RT-2 논문 Figure 1 캡션
이 글은 VLA 시리즈 3편이다. 1편에서 VLA가 왜 등장했는지, 2편에서 백본·액션 표현·액션 헤드가 어떻게 조립되는지를 봤다. 이번에는 2023년부터 2026년까지 실제로 나온 모델들을 시간순으로 세워 놓고, 누가 무엇을 바꿨는지 따라간다. 수치는 논문과 공식 모델 카드에서 확인한 것만 적었고, 2026년 모델은 공식 페이지를 직접 열어 확인한 것만 넣었다. 다음 4편에서는 이 모델들이 먹는 데이터 쪽으로 넘어간다.
🤔 왜 계보를 그려야 하나
VLA는 3년 사이에 "55B 모델을 클라우드 TPU에서 1~3Hz로 돌리는 실험"에서 "0.45B 모델을 노트북 GPU에서 돌리며 커뮤니티 데이터로 파인튜닝하는 도구"까지 넓어졌다. 같은 이름(VLA)을 쓰지만 액션을 만드는 방식은 디스크리트 토큰, 디퓨전, 플로우 매칭, 다시 단일 자기회귀 스트림으로 갈라졌고, 공개 여부도 완전 비공개(RT-2, Gemini Robotics)부터 Apache-2.0(SmolVLA, openpi 코드)까지 폭이 넓다. 어떤 모델을 가져다 쓸지 고르려면 적어도 네 가지는 알아야 한다. 백본이 무엇인지, 액션 헤드가 무엇인지, 가중치가 열려 있는지, 열려 있다면 상업 이용이 되는지다. 이 글은 그 네 가지를 한 표에 모으는 것이 목표다.
📊 비교표: 2023–2026 주요 VLA
| 모델 | 발표 | 조직 | 파라미터 | 백본 | 액션 헤드 | 가중치 | 라이선스 |
|---|---|---|---|---|---|---|---|
| RT-2 | 2023.07 | Google DeepMind | 5B / 55B (PaLI-X), 12B (PaLM-E) | PaLI-X, PaLM-E | 텍스트 토큰(256 bin 이산화) | 비공개 | — |
| Octo | 2024.05 | UC Berkeley 등 | 27M (Small) / 93M (Base) | 자체 트랜스포머(ViT-S/B 규모) + T5-base 언어 인코더 | 디퓨전 MLP 헤드 | 공개 | 코드 MIT |
| OpenVLA | 2024.06 | Stanford 등 | 7B | Llama 2 7B + DINOv2·SigLIP | 텍스트 토큰(이산화) | 공개 | MIT |
| π0 | 2024.10 | Physical Intelligence | 3.3B (VLM 3B + 액션 익스퍼트 300M) | PaliGemma 3B | 플로우 매칭 액션 익스퍼트 | 공개(openpi, 2025.02) | 코드 Apache-2.0 |
| π0.5 | 2025.04 | Physical Intelligence | 미공개(π0 기반) | 웹 학습 VLM(π0 구조) | FAST 토큰 사전학습 → 플로우 매칭 익스퍼트 | 공개(openpi pi05_base) |
코드 Apache-2.0 |
| GR00T N1 | 2025.03 | NVIDIA | 2.2B (VLM 1.34B) | Eagle-2 VLM | 플로우 매칭 DiT | 공개 | NVIDIA 비상업 |
| GR00T N1.5 | 2025 | NVIDIA | 3B | SigLIP2 + T5 (Eagle 계열) | 플로우 매칭 DiT | 공개 | NVIDIA 비상업 |
| SmolVLA | 2025.06 | Hugging Face | 0.45B (익스퍼트 약 100M) | SmolVLM-2 (앞 16층만) | 플로우 매칭 익스퍼트 | 공개 | Apache-2.0 |
| Galaxea G0 | 2025.09 | Galaxea | 미공개(PaliGemma 초기화) | PaliGemma(System 1) + Qwen2.5-VL(System 2) | 플로우 매칭 익스퍼트 | 공개 | Apache-2.0(초기 커밋) |
| π*0.6 | 2025.11 | Physical Intelligence | VLM 5B + 액션 익스퍼트 | 미공개 | 액션 익스퍼트 + Recap(RL) | 비공개 | — |
| Gemini Robotics 1 / 1.5 | 2025.03 / 2025.09 | Google DeepMind | 미공개 | Gemini 2.0 | 미공개 | 비공개(파트너 한정) | — |
| GR00T N1.7 | 2026 | NVIDIA | 3B | Cosmos-Reason2-2B (Qwen3-VL 구조) | 플로우 매칭 DiT (16층) | 공개 | NVIDIA Open Model License |
| π0.7 | 2026.04 | Physical Intelligence | 미공개 | 미공개 | 액션 익스퍼트 + 상위 정책 + 월드 모델 | 비공개 | — |
| Galaxea G0.5 | 2026.06 | Galaxea | 2B급 (Qwen3.5 2B 초기화) | Qwen3.5 2B | 단일 자기회귀 스트림(RVQ 액션 토큰) | 공개(gated) | G0.5 Community(비상업) |
| Gemini Robotics 2 | 2026.07 | Google DeepMind | 미공개 | 미공개 | 미공개 | 비공개(얼리액세스) | — |
표 읽는 법 몇 가지. "미공개"는 논문·모델 카드에 숫자가 없다는 뜻이지 모델이 없다는 뜻이 아니다. 라이선스 열은 가중치 기준이며, 코드 라이선스와 다를 때는 그렇게 적었다. 예를 들어 openpi 저장소는 Apache-2.0이지만 LICENSE_GEMMA.txt가 함께 들어 있어 Gemma 약관이 백본에 얹힌다. GR00T N1.7은 README가 "Apache 2.0으로 상업 이용 가능"이라고 쓰면서 같은 페이지에서 "가중치는 NVIDIA Open Model License"라고 적어 두 문장이 서로 맞지 않는다. 모델 카드는 후자를 따르므로 표에도 후자를 썼다.
🧠 1세대(2023): 행동을 텍스트로 — RT-2
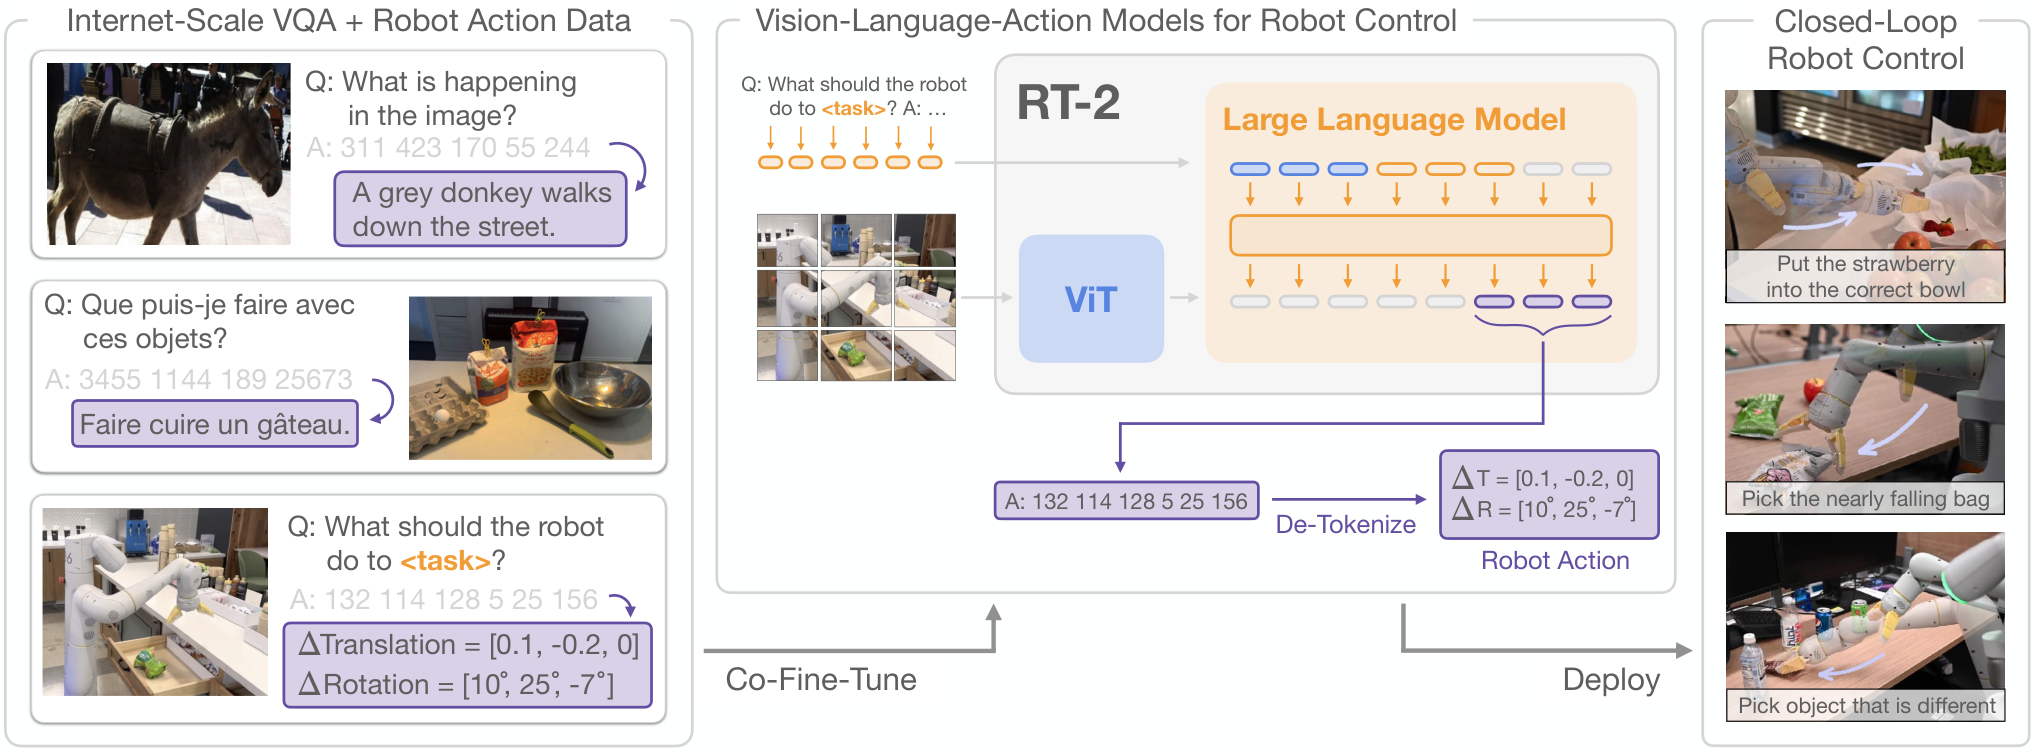
RT-2(2023년 7월)는 VLM을 로봇 정책으로 바꾸는 가장 단순한 길을 택했다. 6자유도 엔드이펙터 변위와 그리퍼, 종료 신호를 각각 256개 구간으로 균등 이산화하고, 그 정수를 텍스트 토큰으로 쓴다. PaLI-X에서는 기존 정수 토큰에 그대로 매핑하고, PaLM-E에서는 "가장 드물게 쓰이는 256개 토큰을 덮어써" 액션 어휘로 삼았다. 백본은 PaLI-X 5B·55B와 PaLM-E 12B였고, 인터넷 VQA 데이터와 로봇 데이터를 섞어 co-fine-tune했다.
대가는 추론 비용이다. 55B 모델은 클라우드의 여러 TPU에서 돌아가고 로봇은 네트워크로 질의하며, 주파수는 1~3Hz(5B는 약 5Hz)에 그친다. 가중치는 공개되지 않았고 논문도 "오픈소스 VLM이 더 나오길 바란다"고 적었다. 그 바람을 이듬해 두 팀이 받아들였다.
🧠 2세대(2024): 공개 모델의 두 갈래 — Octo와 OpenVLA
Octo(2024년 5월)는 VLM을 쓰지 않는다. ViT-S·ViT-B 규모의 트랜스포머를 처음부터 학습하고(27M·93M), 언어는 T5-base(111M)로 16개 토큰을 뽑아 넣고, 액션은 디퓨전 MLP 헤드(3층, 은닉 256, 20 스텝)가 만든다. 학습 데이터는 Open X-Embodiment에서 고른 25개 데이터셋 약 80만 궤적이다. "작고 열려 있고 어떤 로봇에든 붙이기 쉬운 범용 정책"이 목표였고, 코드는 MIT다.
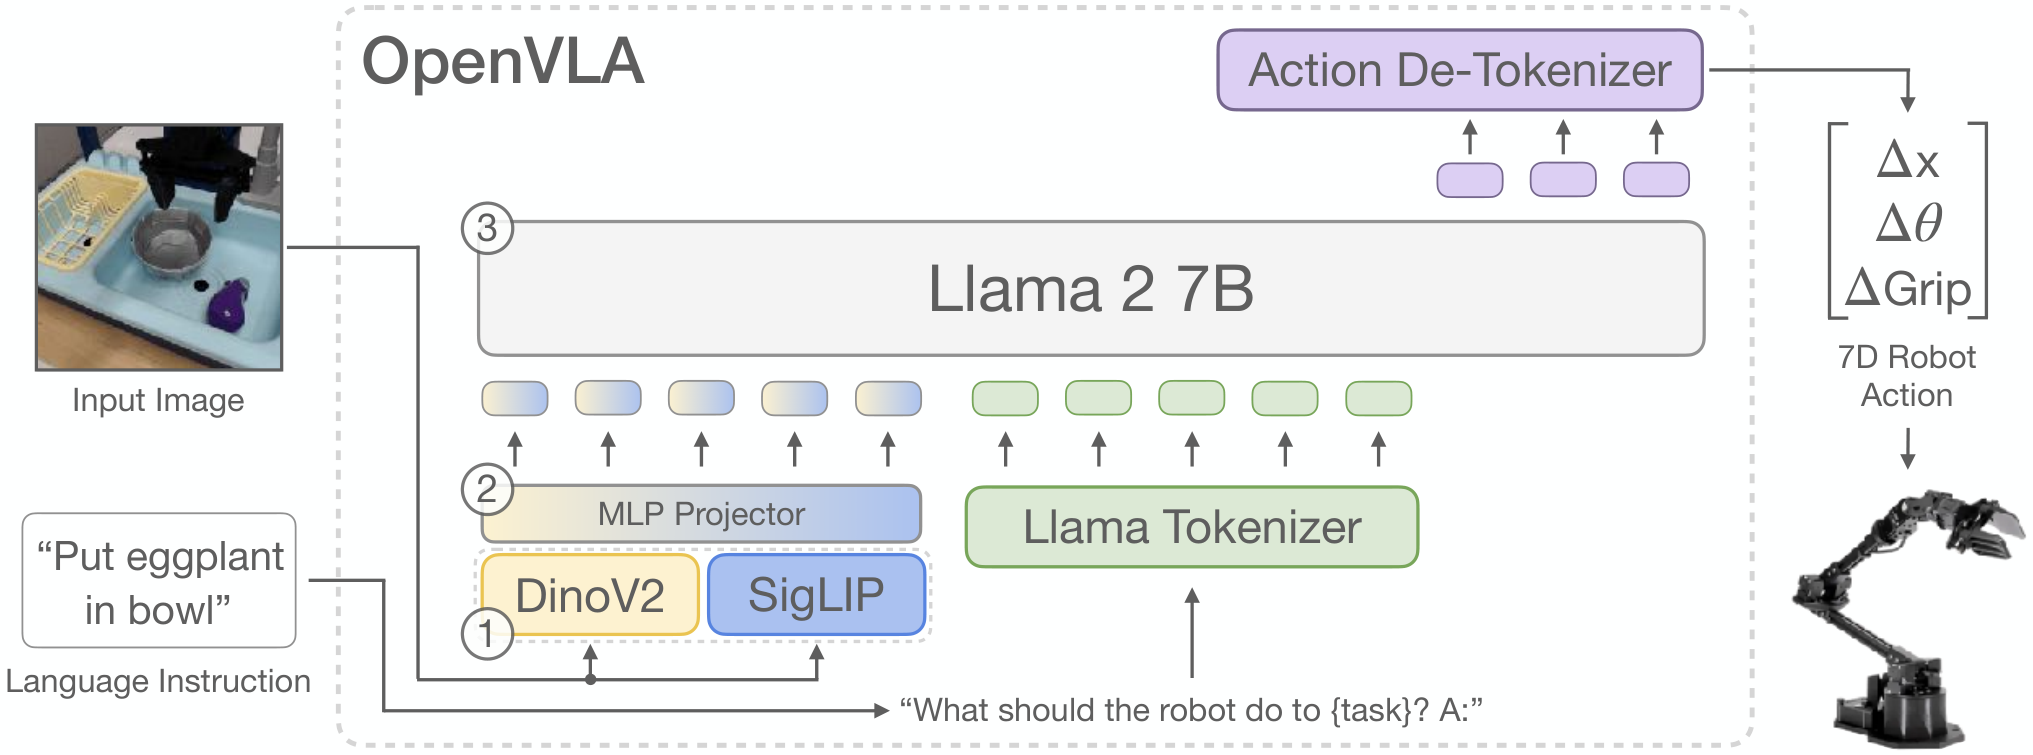
OpenVLA(2024년 6월)는 RT-2의 레시피를 공개 재료로 다시 만든 쪽이다. Prismatic VLM 계열의 DINOv2 + SigLIP 이중 인코더와 Llama 2 7B를 쓰고, 액션은 RT-2처럼 이산 토큰으로 낸다. OXE에서 97만 에피소드로 학습했고, 가중치는 MIT 라이선스로 Hugging Face에 올라와 있다. 2024년 하반기 VLA 파인튜닝 실험의 사실상 기준점이 됐지만, 7B 자기회귀 디코딩은 느리고 이산화는 정밀 조작에 약하다는 문제를 그대로 안고 있었다. 이 두 문제에 대한 답이 다음 세대의 출발점이다.
🧠 3세대(2024–25): 플로우 매칭 액션 익스퍼트 — π0, π0.5, GR00T, SmolVLA
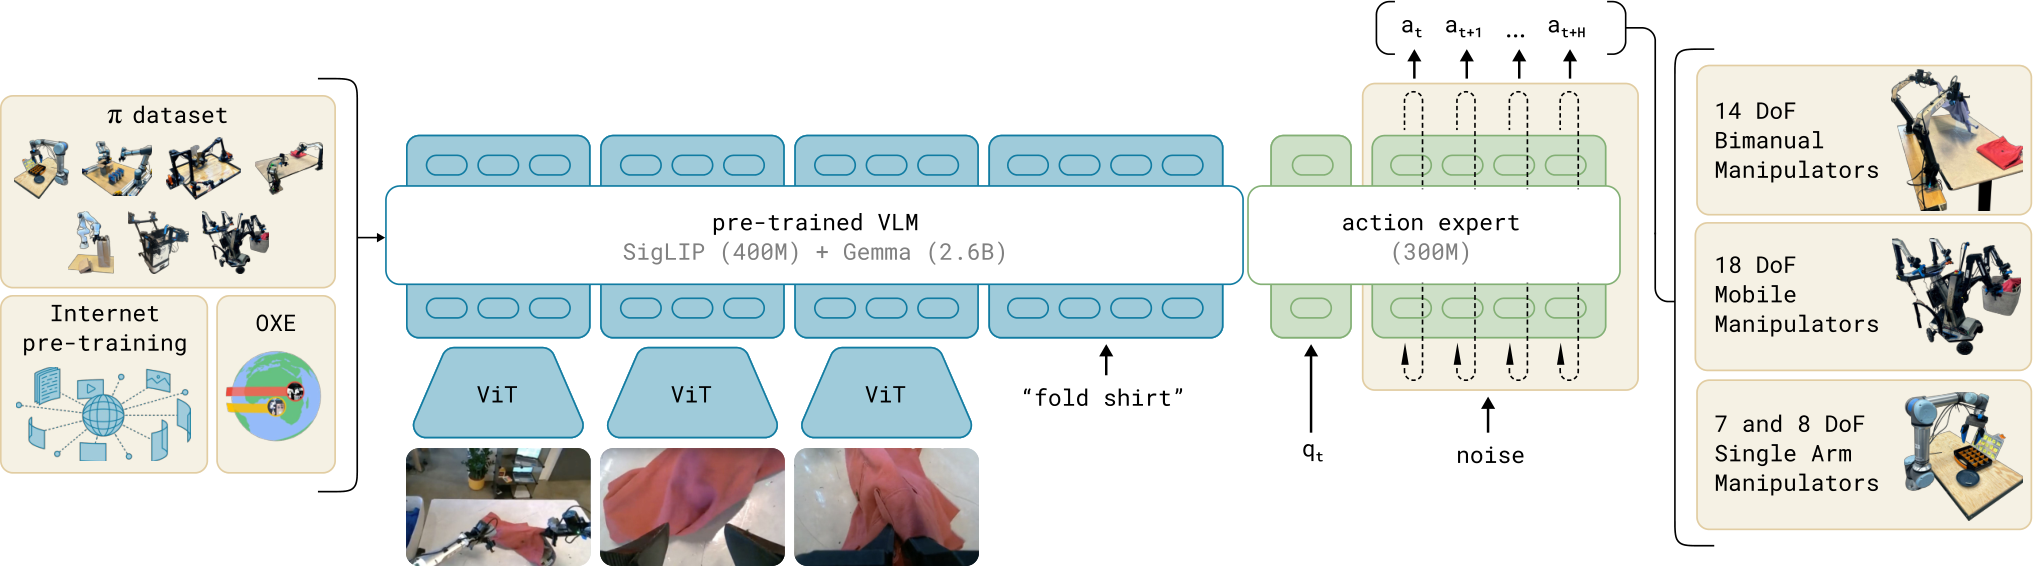
π0(2024년 10월)가 바꾼 것은 액션을 만드는 자리다. PaliGemma 3B를 백본으로 두고, 그 옆에 처음부터 초기화한 300M 액션 익스퍼트를 붙여 총 3.3B를 만들었다. 익스퍼트는 조건부 플로우 매칭으로 50 스텝짜리 액션 청크를 연속값으로 내고, 50Hz까지 제어한다. 데이터는 7종 로봇 구성에서 모은 1만 시간 이상의 자체 데이터에 OXE를 섞었다. 2025년 2월 openpi로 π0와 π0-FAST의 가중치·코드가 공개됐고, 저장소는 Apache-2.0이다. 플로우 매칭 수식 자체는 2편에 적어 두었다.
π0.5(2025년 4월)는 같은 구조 위에서 학습 레시피를 바꿨다. 1단계 사전학습은 FAST 이산 토큰으로 28만 스텝, 2단계 사후학습에서 플로우 매칭 익스퍼트를 붙여 8만 스텝을 더 돌린다. 추론 시에는 먼저 텍스트로 하위 작업을 예측한 뒤 그 조건으로 저수준 액션을 낸다. 모바일 매니퓰레이터 약 400시간을 포함해 여러 로봇·웹 데이터를 섞었고, 학습에 없던 세 집에서 2~5분짜리 과제를 수행했다. openpi에 pi05_base가 올라와 있는데 "플로우 매칭 헤드만 지원"한다고 명시돼 있다. 파라미터 수는 논문 본문에서 확인하지 못했다.
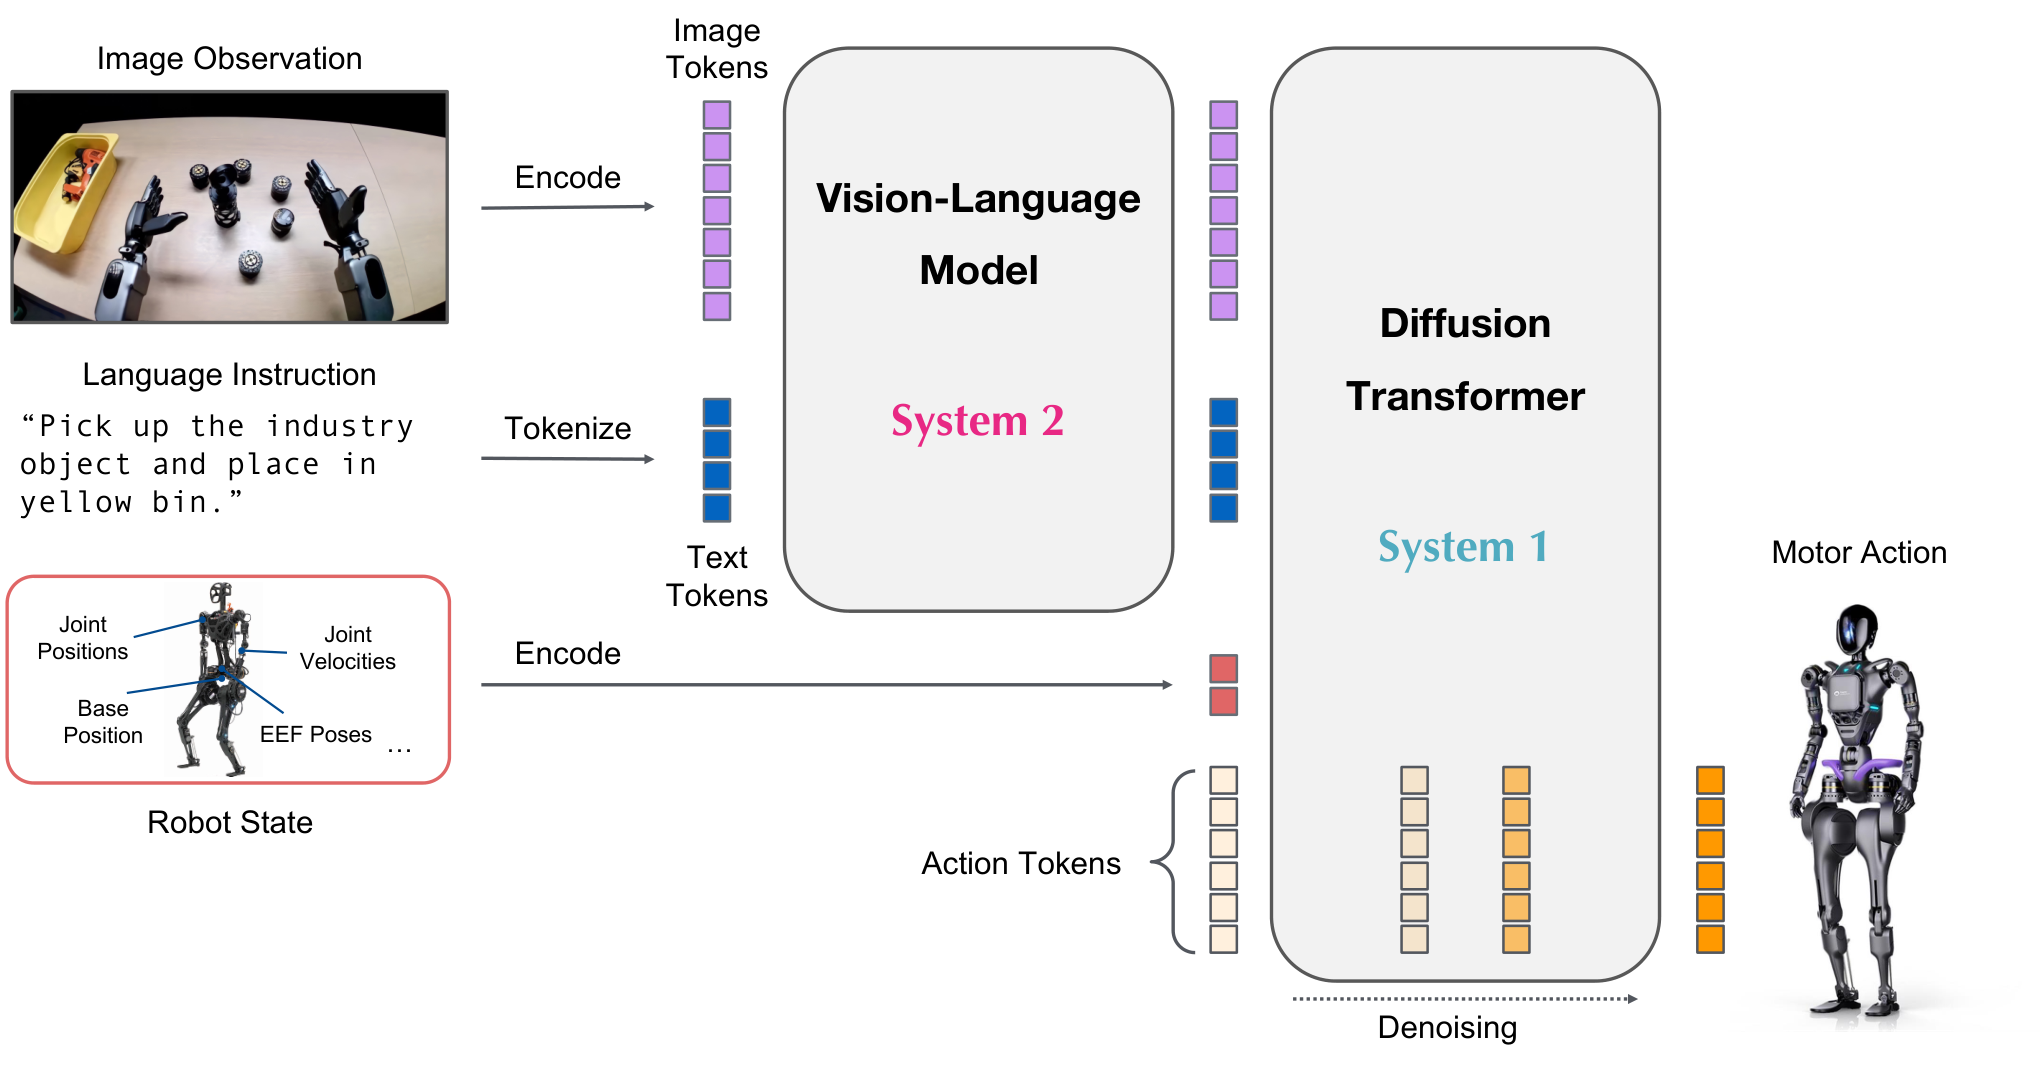
GR00T N1(2025년 3월)은 같은 발상을 "System 2 / System 1"이라는 이름으로 포장했다. Eagle-2 VLM(1.34B)이 10Hz로 관측을 해석하고, 플로우 매칭으로 학습한 디퓨전 트랜스포머가 120Hz로 액션을 만든다. 공개 모델은 2.2B이고, 16개 액션 청크 한 번 샘플링에 L40 GPU bf16 기준 63.9ms가 든다. 이어진 N1.5(3B)는 VLM 특징과 DiT 사이의 MLP 커넥터를 손보고 플로우 매칭과 월드 모델링 목표를 같이 학습했다. N1·N1.5·N1.6까지의 가중치는 모두 NVIDIA 비상업 라이선스였다.
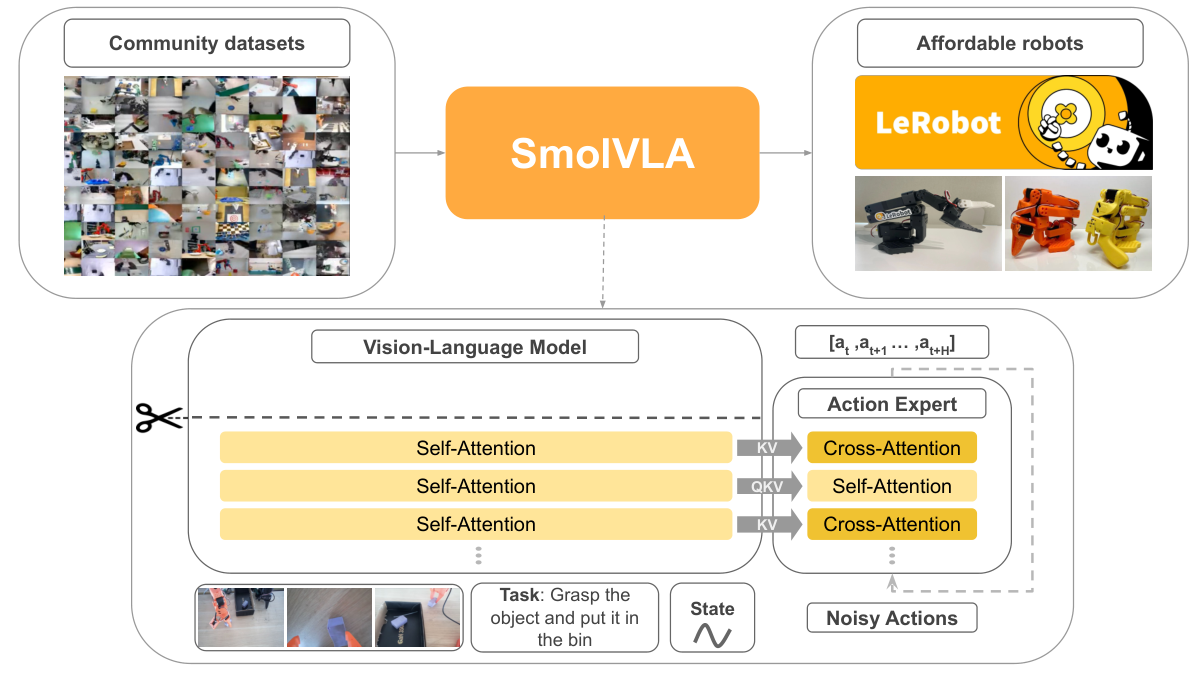
SmolVLA(2025년 6월)는 같은 구조를 4억 5천만 파라미터로 줄였다. SmolVLM-2에서 앞 16층만 쓰고, 익스퍼트(약 100M)는 cross-attention과 self-attention을 번갈아 쌓는 플로우 매칭 트랜스포머다. 사전학습 데이터는 Hugging Face 커뮤니티가 올린 481개 데이터셋, 약 2만 3천 에피소드(1,060만 프레임)에 불과하다. 모델과 코드, 데이터 모두 Apache-2.0이고 LeRobot에 통합돼 있어 5편 실습의 주인공이 된다.
Galaxea G0(2025년 9월)도 이 계열이다. PaliGemma로 초기화한 G0-VLA(System 1)가 플로우 매칭 익스퍼트로 액션을 내고, Qwen2.5-VL 기반 G0-VLM(System 2)이 계획을 맡는다. 특징은 3단계 학습 커리큘럼이다. 크로스 임바디먼트 사전학습(OXE 약 1,000시간 + 자체 200시간, FAST 토큰) → 단일 임바디먼트 사전학습(자체 Galaxea Open-World Dataset 500시간, 10만 궤적) → 100궤적 이하의 사후학습. 논문은 두 번째 단계, 즉 "한 로봇 플랫폼에서만 모은 데이터로 한 번 더 사전학습"이 성능에 특히 중요하다고 강조한다.
🧠 4세대(2025 하반기–2026): RL, 조향, 다시 자기회귀
이 시기 모델들은 구조보다 학습 신호를 바꾸고 있다. 그리고 공개 여부가 뚜렷이 갈린다.
π*0.6 (2025년 11월). 백본을 5B VLM으로 키운 π0.6 위에 Recap(RL with Experience & Corrections via Advantage-conditioned Policies)을 얹었다. 시연, 전문가 텔레오퍼레이터의 개입(correction), 자율 실행 경험을 모두 쓰되, 가치 함수를 학습해 어드밴티지를 계산하고 정책을 어드밴티지에 조건화한다. 나쁜 데이터도 버리지 않는다. 블로그는 "가장 어려운 과제에서 처리량이 2배 이상, 실패율이 절반 이하"라고 주장하며(벤더 주장), 에스프레소 제조는 단계별 90% 이상 성공률을 든다. 가중치 공개에 대한 언급은 없다. RL 사후학습의 상세는 6편에서 다룬다.
π0.7 (2026년 4월 16일, pi.website 확인). "조향 가능한(steerable) 모델"이라는 이름대로 언어 지시 외에 메타데이터(품질·속도), 제어 모달리티(관절 vs 엔드이펙터), 시각 하위 목표를 프롬프트로 받는다. 시각 하위 목표는 경량 월드 모델이 생성한다. 블로그는 학습에 없던 에어프라이어 사용, 학습 데이터가 전혀 없는 양팔 UR5e에서의 빨래 개기를 "구성적 일반화의 첫 징후"로 소개한다. 백본, 파라미터 수, 가중치·API 모두 블로그에 적혀 있지 않다. 2026년 10월 13일 글은 최신 모델을 "Pi API 베타"로 제공한다고 하는데, 이는 클라우드 추론 서비스이지 가중치 공개가 아니다.
GR00T N1.7 (2026, NVIDIA GitHub·HF 모델 카드 확인). 백본을 Eagle에서 Cosmos-Reason2-2B(Qwen3-VL 구조)로 바꿨고, 네이티브 종횡비 이미지를 받는다. DiT는 32층에서 16층으로 줄이고 액션 호라이즌은 16에서 40으로, 상태·액션 차원은 29에서 132로 늘렸다. 사전학습에는 로봇 데이터 외에 EgoScale 사람 비디오 2만 시간이 들어갔다. LIBERO 배치 1 기준 RTX PRO 6000에서 약 40Hz, Jetson AGX Thor에서 약 28Hz(TensorRT)라고 한다. 가중치 라이선스가 NVIDIA Open Model License로 바뀌어 모델 카드에 "상업/비상업 이용 가능"이라고 적힌 첫 GR00T다. 정확한 공개일은 README와 모델 카드 어디에도 없어 표에는 연도만 적었다.
Gemini Robotics 1 → 1.5 → 2 (deepmind.google 확인). 1(2025년 3월 12일)은 Gemini 2.0 위에 "물리 행동을 출력으로 추가"한 VLA였고, ALOHA 2 데이터로 주로 학습했으며 Franka 양팔과 Apptronik Apollo에도 적용했다. 1.5(2025년 9월 25일)는 행동 전에 자연어로 "생각"하고, 한 로봇에서 배운 동작을 다른 로봇으로 옮기는 motion transfer를 내세웠다. 2(2026년 7월 30일)는 VLA·ER 2(구현 추론)·On-Device 2 세 모델이며, "처음으로 휴머노이드 전신을 제어"한다. Apollo 2가 걸어가 물뿌리개를 집어 선반 위 상자에 넣는 시연, 22자유도 SharpaWave 손 제어가 있다. 공개된 벤치마크 수치는 선반에서 집기 76.3%, 바닥에서 집기 45.7%, 전구 돌려 끼우기 36%로, 블로그 스스로 "다지 손 조작은 여전히 어렵다"고 적었다. 세 세대 모두 파라미터·백본 크기는 공개되지 않았고, VLA는 파트너·얼리액세스 한정이다. ER 2만 AI Studio에서 gemini-robotics-er-2-preview로 열려 있다.
Galaxea G0.5 (2026년 6월 공개, 8월 arXiv 2608.11739, GitHub 확인). 이 계보에서 가장 흥미로운 방향 전환이다. 3세대가 "VLM은 인코더, 액션은 별도 익스퍼트"로 굳어졌는데, G0.5는 Qwen3.5 2B에서 초기화한 단일 트랜스포머 디코더 하나가 추론 토큰과 액션 토큰을 한 스트림에서 생성한다. 액션은 학습된 residual VQ 토크나이저로 이산화하고, 서로 다른 로봇을 27차원 공통 레이아웃(양팔·양 그리퍼·하체)에 맞춘다. 체인오브소트 구간에는 Subtask, BBox, Trace, ActionHint 필드가 들어가고, 5초 창에서 6프레임의 시각 메모리를 쓴다. 논문은 R1lite/R1pro 실제 파인튜닝 76.7%(π0.5 53.3%), DROID 제로샷 82.5%, LIBERO 98.9%를 보고한다. 가중치는 Hugging Face OpenGalaxea/G05에 gated로 올라와 있고(체크포인트 약 11GB), 라이선스는 비상업 Community License다. RT-2가 "행동은 언어다"로 시작했다가 π0 계열이 연속 액션 익스퍼트로 갈라졌고, 2026년에 더 좋은 토크나이저를 들고 다시 자기회귀로 돌아오는 모습이다. 2편에서 본 액션 토큰화 논쟁이 아직 끝나지 않았다는 뜻이기도 하다.
🔍 계보에서 읽히는 네 가지 흐름
첫째, 백본은 작아지고 공개 VLM으로 수렴한다. RT-2의 55B PaLI-X에서 π0의 PaliGemma 3B, GR00T N1.7의 Cosmos-Reason2-2B, G0.5의 Qwen3.5 2B, SmolVLA의 0.45B로 내려왔다. 비공개 거대 백본은 Gemini Robotics 계열만 남았다. 로봇 쪽 제어 주파수와 온디바이스 요구가 LLM 쪽의 스케일링 유혹을 이기고 있다.
둘째, 액션 헤드는 플로우 매칭으로 한 번 모였다가 다시 갈라진다. 2024년 말부터 π0, GR00T, SmolVLA, G0가 모두 "VLM + 플로우 매칭 익스퍼트"였다. 그런데 π0.5는 사전학습을 FAST 토큰으로 하고, G0.5는 아예 익스퍼트를 없앴다. 익스퍼트가 VLM의 추론 능력을 액션에 충분히 전달하지 못한다는 문제의식이 공통이다.
셋째, 제어 주파수가 표준 비교 축이 됐다. RT-2는 클라우드 TPU에서 1~3Hz였고, π0는 50Hz 제어를 내세웠으며, GR00T N1은 액션 모듈이 120Hz로 돈다고 적었다. N1.7은 아예 TensorRT 기준 Jetson AGX Thor에서 28Hz라는 온디바이스 수치를 README 첫머리에 올린다. 다만 이 숫자들은 "액션 청크 한 번 생성"인지 "청크 안의 액션 실행 주파수"인지가 모델마다 다르니, 2편에서 정리한 추론 주파수의 정의를 염두에 두고 읽어야 한다. SmolVLA가 제안한 비동기 추론은 이 두 숫자를 아예 분리해 버린 접근이다.
넷째, "공개"의 뜻이 세분화됐다. 완전 비공개(RT-2, Gemini Robotics VLA, π0.7), 가중치는 있지만 비상업(GR00T N1~N1.6, G0.5), 가중치 공개에 상업 허용(OpenVLA MIT, SmolVLA Apache-2.0, GR00T N1.7 NVIDIA Open Model License), 코드만 Apache-2.0이고 백본 약관이 얹히는 경우(openpi + Gemma)가 모두 다르다. 제품에 넣을 생각이라면 모델 카드의 라이선스 파일을 직접 열어 봐야 한다.
⚠️ 한계와 주의
- 표의 성공률은 각 조직이 자기 과제·자기 로봇에서 잰 값이라 모델 간 직접 비교가 안 된다. G0.5가 π0.5를 이겼다는 숫자도 Galaxea가 자사 로봇에서 재현한 π0.5 기준이다.
- 2026년 모델 중 π0.7, Gemini Robotics 2는 파라미터·백본이 비공개라 표의 빈칸이 많다. 비어 있는 칸을 추정값으로 채우지 않았다.
- GR00T N1.7의 공개일은 1차 출처에서 확인하지 못했다(README·모델 카드에 날짜 없음). 보도 자료에 의존하는 날짜는 적지 않았다.
- 라이선스는 2026년 11월 3일 기준이며 바뀔 수 있다. 특히 GR00T N1.7은 README와 모델 카드의 문구가 서로 다르다.
📚 참고
- RT-2: arXiv 2307.15818
- Octo: arXiv 2405.12213, github.com/octo-models/octo
- OpenVLA: arXiv 2406.09246, HF openvla/openvla-7b
- π0: arXiv 2410.24164, openpi
- π0.5: arXiv 2504.16054
- π*0.6: pi.website/blog/pistar06 (2025-11-17)
- π0.7: pi.website/blog/pi07 (2026-04-16)
- GR00T N1: arXiv 2503.14734, HF nvidia/GR00T-N1-2B
- GR00T N1.5 / N1.6 / N1.7: HF N1.5-3B, HF N1.6-3B, HF N1.7-3B, github.com/NVIDIA/Isaac-GR00T
- Gemini Robotics: 1 (2025-03-12), 1.5 (2025-09-25), 2 (2026-07-30), 모델 페이지
- SmolVLA: arXiv 2506.01844, HF lerobot/smolvla_base
- Galaxea G0: arXiv 2509.00576; G0.5: arXiv 2608.11739, github.com/OpenGalaxea/GalaxeaVLA
본 글의 그림은 각 논문/공식 블로그에서 가져왔습니다(RT-2 Fig.1, OpenVLA Fig.2, π0 Fig.3, GR00T N1 Fig.2, SmolVLA Fig.1).