H-JEPA: 잠재 공간을 층층이 쌓아 더 먼 미래를 계획하는 월드 모델
"다리를 어떻게 움직일지와 미로의 어느 복도로 갈지는 같은 공간에서 생각할 문제가 아니다."
2026년 10월, NYU·Meta AMI·INRIA·Brown의 Wancong Zhang, Basile Terver, Michael Rabbat, Yann LeCun, Randall Balestriero가 H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning 을 공개했다. 행동 조건부 JEPA 월드 모델을 여러 층으로 쌓되, 각 층이 자기만의 잠재 공간에서 더 긴 시간 단위로 미래를 예측하게 하고, 그 계층을 reward도 픽셀 복원도 없이 end-to-end로 학습하는 방법이다. 계획(planning)은 위에서 아래로 내려간다. 맨 위 레벨이 목표까지의 거친 경로를 그리면, 그 예측이 아래 레벨의 서브골이 되고, 맨 아래 레벨이 실제 행동을 내놓는다.
원문: https://arxiv.org/abs/2610.06805 · 프로젝트 페이지: h-jepa.com · 코드: github.com/kevinghst/H-JEPA
🤔 배경: JEPA 월드 모델과 "한 층"의 한계
월드 모델은 환경의 동역학을 경험에서 배워 에이전트가 예측하고 계획할 수 있게 하는 모델이다. LeCun이 제안한 JEPA(Joint-Embedding Predictive Architecture) 는 이를 픽셀이 아니라 잠재 공간에서 한다. 다음 프레임의 모든 픽셀을 그리는 대신, 인코더가 만든 다음 상태의 임베딩을 예측하도록 인코더와 예측기를 함께 학습한다. 예측할 수 없는 세부(조명 노이즈, 배경의 미세한 흔들림)는 잠재 공간에서 자연스럽게 버려지고, 보상 신호도 픽셀 복원 손실도 필요 없다. 여기에 행동을 조건으로 넣으면 DINO-WM, V-JEPA 2-AC, PLDM, LeWM 같은 행동 조건부 JEPA 월드 모델이 되고, 학습된 잠재 공간에서 행동 시퀀스를 최적화해 zero-shot으로 계획할 수 있다.
문제는 이 모델들이 단일 잠재 공간, 단일 시간 단위에서 예측하고 계획한다는 점이다. 저자들은 두 가지 한계를 짚는다.
- 긴 horizon은 짧은 스텝을 많이 굴려야 한다. 예측 오차가 누적되고, 행동 탐색 공간도 horizon에 비례해 커진다.
- 하나의 잠재 공간이 두 가지 일을 동시에 해야 한다. 저수준 동역학을 잘 모델링하려면 빠르게 변하는 세부(다리 자세 등)를 담아야 하지만, 그런 공간에서 "목표 이미지와의 거리"를 재면 목표보다 훨씬 구체적인 것을 맞추려는 비용이 된다. 미로에서 목표는 "이 위치에 도달"인데, 비용은 "이 다리 자세까지 똑같이"를 요구하는 셈이다.
가장 가까운 선행 연구인 HWM(Zhang et al., 2026)은 여러 horizon의 예측기를 두고 계층적으로 계획하지만, 모든 예측기가 하나의 잠재 공간을 공유한다. 시간은 쪼개도 "더 추상적인 공간에서 목표를 비교"할 수는 없었다. H-JEPA는 바로 그 지점을 채운다.
🧠 핵심 아이디어: 레벨마다 자기 잠재 공간, 자기 시간 단위
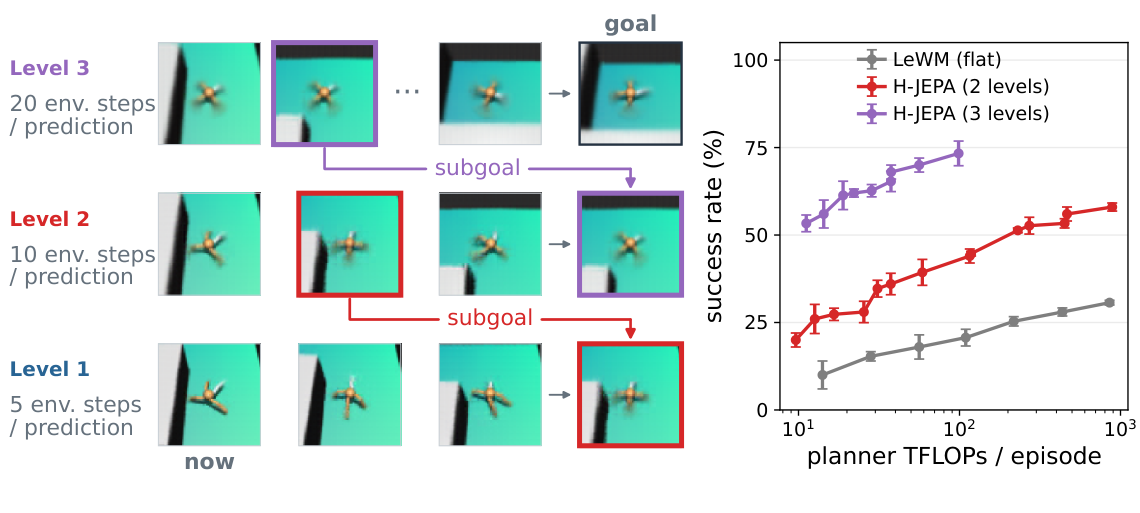
그림 1이 전체를 요약한다. 레벨 1은 환경 5스텝마다 한 번 예측하고, 레벨 2는 10스텝, 레벨 3은 20스텝마다 예측한다. 각 레벨을 디코딩해 보면 위로 갈수록 개미의 다리 자세가 뭉개지고 위치와 미로 벽만 남는다. 오른쪽 그래프에서 3레벨 모델은 약 100 TFLOPs에서 73% 성공률에 도달하는데, flat LeWM은 그 10배 가까운 계산을 써도 30%를 넘지 못한다.
구조: 스트라이드 과 윈도
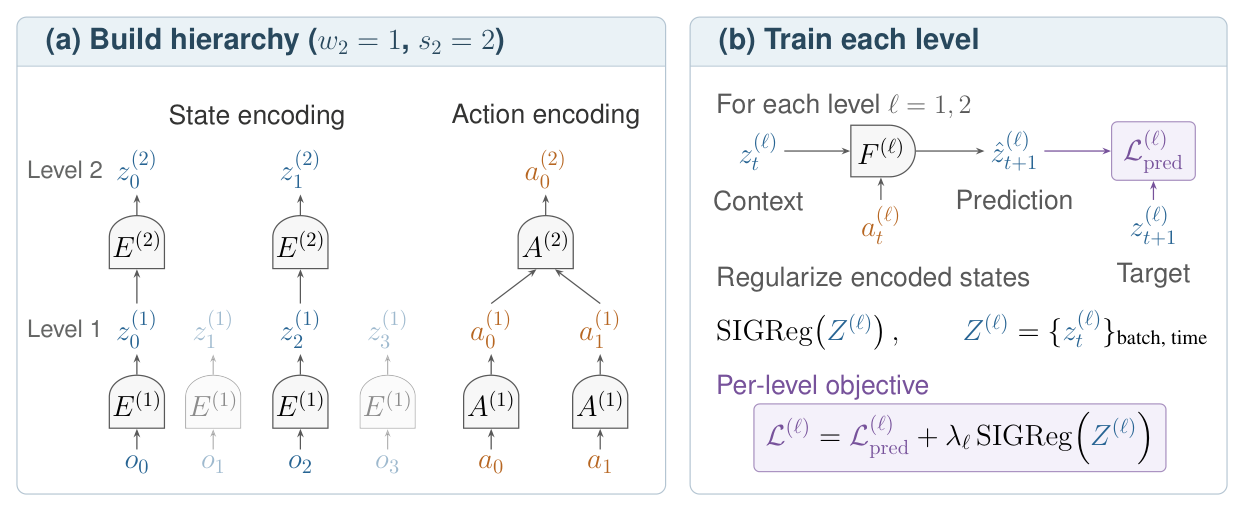
레벨 1은 LeWM 그대로다. ViT-Tiny 인코더가 이미지를 [CLS] 토큰 하나로 요약하고(), 행동 인코더가 행동 블록을 임베딩하며(), causal transformer 예측기 이 다음 잠재를 예측한다. 상위 레벨 은 아래 레벨의 잠재를 입력으로 받아 같은 구조를 반복한다. 두 개의 시간 하이퍼파라미터가 있다.
- 스트라이드 : 상위 레벨 한 스텝이 하위 레벨 몇 스텝에 해당하는지(얼마나 건너뛰는지).
- 윈도 : 상위 레벨 상태 하나가 하위 레벨 상태 몇 개를 요약하는지(얼마나 넓게 보는지).
논문의 모든 실험은 을 쓴다. 즉 상위 상태 인코더는 하위 잠재 하나를 점별(pointwise)로 변환하는 2층 MLP이고, 행동 인코더만 사이에 낀 개의 하위 행동 임베딩을 작은 transformer로 뭉쳐 "매크로 행동"을 만든다. 시뮬레이션 환경은 (레벨마다 시간 단위 2배), DROID는 이다.
학습: 레벨마다 JEPA 손실 + SIGReg, 전부 end-to-end
각 레벨은 자기 잠재 공간에서 teacher-forced 1스텝 예측 손실을 최소화한다.
이 손실만 쓰면 인코더가 모든 입력을 상수로 보내 버리는 collapse가 최적해가 된다(상수는 완벽히 예측 가능하니까). H-JEPA는 LeJEPA의 SIGReg를 레벨마다 건다. 배치·시간을 펼친 임베딩 행렬 을 개의 랜덤 방향으로 1차원 투영한 뒤, 각 투영이 표준 정규분포와 얼마나 다른지를 Epps–Pulley 통계량으로 재서 평균한다. 임베딩 분포가 등방성 가우시안에 가까워지도록 밀어 collapse를 막는 것이다.
주목할 점은 stop-gradient도, EMA 타깃 인코더도, 사전학습 가중치도 쓰지 않는다는 것이다. 모든 레벨의 손실을 합쳐 한 번에 최적화하며, 상위 레벨의 예측 오차 기울기가 하위 레벨 인코더까지 흘러 내려간다. 부록의 학습 곡선을 보면 4레벨 모델까지 어느 레벨도 예측 손실이 0으로 떨어지지(=collapse) 않고, 상위 레벨일수록 더 큰 예측 손실과 SIGReg 값으로 수렴한다. SIGReg 계수는 한 모델 안에서 모든 레벨이 같은 값을 쓴다(FourRoom 0.18, 나머지 0.09).
📐 Top-down 계획: 위에서 목표를 정하고, 아래가 따라간다
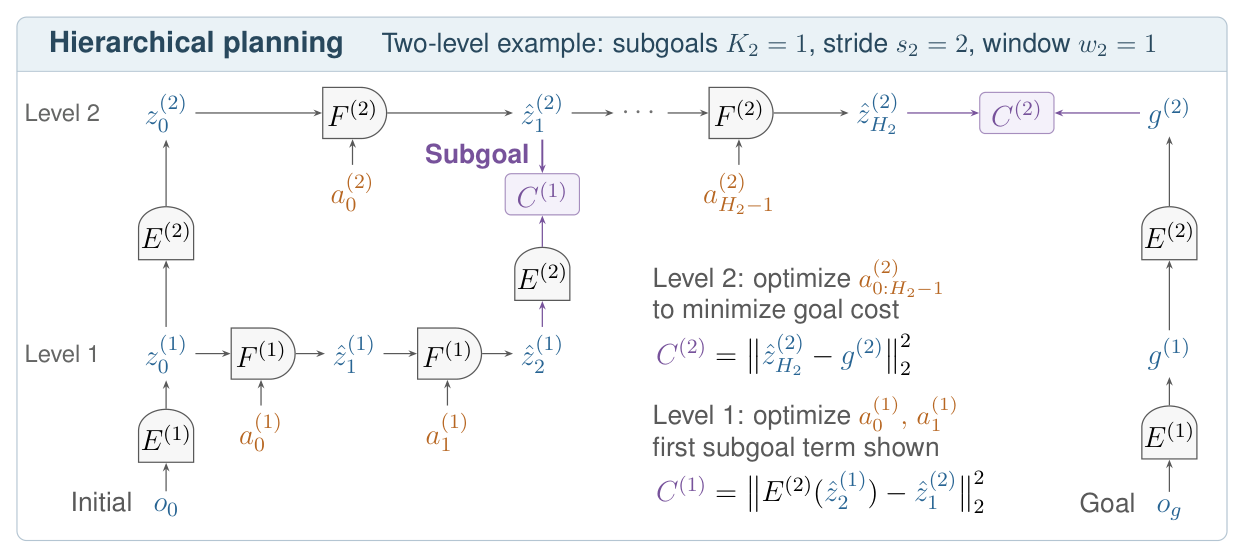
계획은 현재 관측과 목표 관측을 모든 레벨에서 인코딩하는 데서 시작한다. 맨 위 레벨 은 매크로 행동 시퀀스를 최적화해 마지막 예측 상태가 목표 잠재와 가까워지도록 한다.
그 아래 레벨 은 위 레벨이 예측한 궤적 를 서브골로 받는다. 핵심 트릭은 하위 레벨의 예측을 상위 인코더 로 올려서 상위 잠재 공간에서 비교한다는 것이다. 하위 레벨은 자기 동역학으로 굴리되, 비용은 더 추상적인 공간에서 매긴다.
이 과정이 레벨 1까지 재귀적으로 내려가면 원시 행동이 나온다. 모든 레벨에서 행동은 잠재 롤아웃을 미분해 경사하강(AdamW, 최대 90회) 으로 최적화한다. 폐루프 제어에서는 , 즉 바로 다음 서브골 하나만 맞추고, 레벨 1 행동 블록 두 개(환경 10스텝)를 실행한 뒤 처음부터 다시 계획한다. 상위 레벨은 horizon이 1로 줄어들면 건너뛴다.
🔍 왜 상위 레벨은 "느린 것"만 남기나
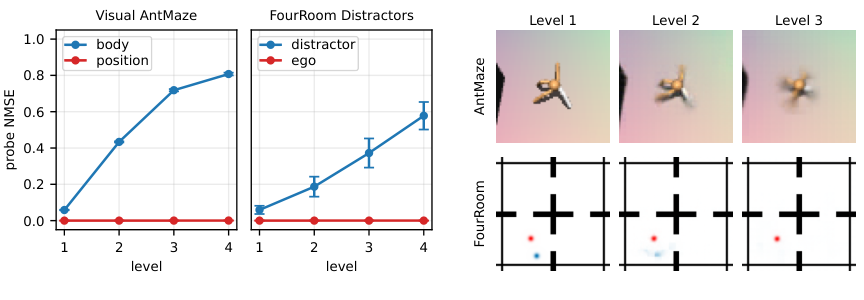
H-JEPA에는 "무엇을 버려라"는 명시적 손실이 없다. 그런데도 상위 레벨은 빠르게 변하는 세부를 버린다. 저자들은 이를 JEPA의 성질로 설명한다. 예측 오차의 기울기가 인코더로 흐르므로, 각 레벨은 자기 시간 단위에서 예측할 수 있는 특징은 유지하고 예측할 수 없는 특징은 추상화해 버리는 쪽으로 학습된다. AntMaze에서 개미의 관절은 전역 위치가 바뀌는 것보다 훨씬 빠르게 진동하고(한 에피소드에서 주기 약 4프레임 vs 35프레임, 주파수 비 8.3배), FourRoom의 방해물은 평균 35스텝마다 무작위 순간이동을 하므로 긴 horizon일수록 예측이 불가능해진다. 그래서 위로 갈수록 몸체 상태와 방해물은 지워지고, 에이전트 위치는 레벨 4까지 또렷하게 남는다.
흥미로운 건 이 현상이 모든 환경에서 나타나지는 않는다는 점이다. 데이터에서 가장 빠른 상태 성분과 가장 느린 성분의 주파수 비(spectral centroid 비)를 재 보면, AntMaze·Humanoid·FourRoom은 3.112.7배로 커서 선택적 추상화가 뚜렷한 반면, Push-T·Cube·DROID는 1.21.6배에 불과해 레벨 2가 레벨 1과 거의 같은 정보를 유지한다. 저자들은 약 2배 아래에서는 추상화가 거의 일어나지 않는다고 본다. 즉 계층이 "느린 구조"를 걸러내려면 데이터 자체에 시간 스케일의 분리가 있어야 한다.
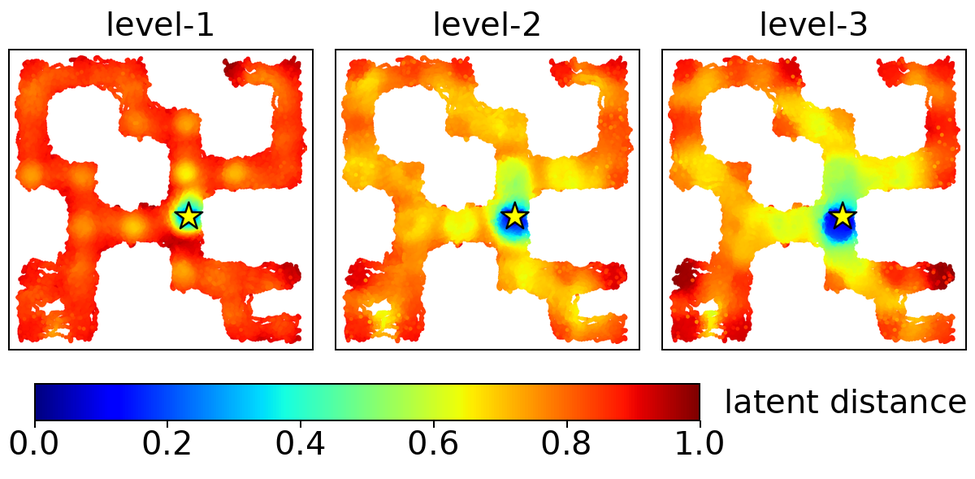
이 추상화는 계획 비용의 모양을 바꾼다. 그림 4에서 레벨 1 잠재 거리는 목표 바로 옆이 아니면 거의 상수라 경사 기반 플래너에게 아무 신호도 주지 못한다. 상위 레벨에서는 거리가 미로의 복도를 따라 부드럽게 증가해, 벽을 돌아가는 최단 경로 길이와 닮은 비용이 된다.
📊 실험: 내비게이션과 조작
환경은 FourRoomDistractors(4개 방 + 방해물, 2D 내비게이션), Visual AntMaze(OGBench, 8자유도 사족 로봇 + 27차원 고유수용 상태), Push-T(T 블록 밀기), OGBench Cube(큐브 집어 놓기) 네 가지다. 최대 4레벨까지 학습하고, 비교 대상은 flat LeWM과 같은 구현·데이터·설정에서 상위 인코더만 항등 함수로 바꾼 HWM이다. 최종 평가는 환경당 50개 과제, 3 seed, 플래너 예산 100 TFLOPs/에피소드 기준으로 설정을 고른다.
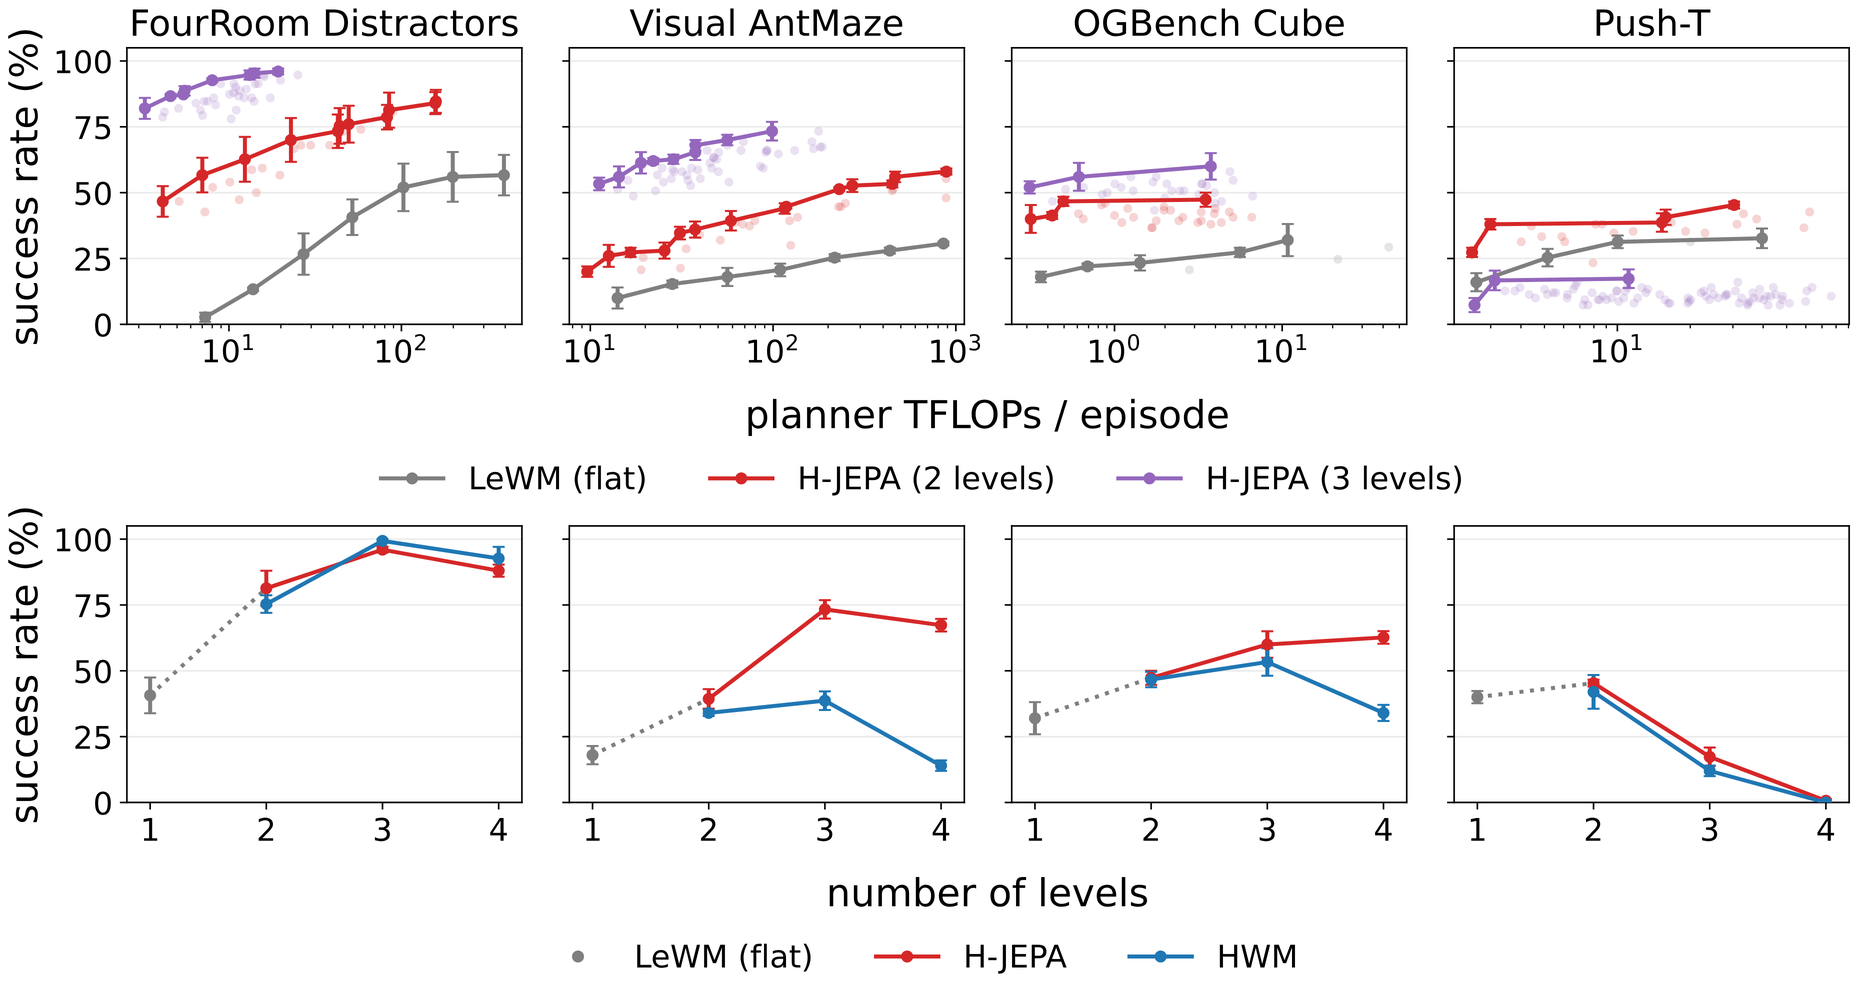
최종 평가 세트 성공률(%)을 표로 정리하면 다음과 같다(부록 Table 1·9).
| 환경 | LeWM (flat) | H-JEPA 2레벨 | 3레벨 | 4레벨 |
|---|---|---|---|---|
| FourRoom Distractors | 40.7 ± 6.8 | 81.3 ± 6.7 | 96.0 ± 1.1 | 80.0 ± 4.0 |
| Visual AntMaze | 18.0 ± 3.5 | 39.3 ± 3.7 | 73.3 ± 3.5 | 63.3 ± 7.7 |
| OGBench Cube | 32.0 ± 6.1 | 47.3 ± 2.7 | 60.0 ± 5.0 | 55.3 ± 4.4 |
| Push-T | 40.0 ± 2.3 | 45.3 ± 1.3 | 17.3 ± 3.5 | 0.7 ± 0.7 |
AntMaze 18% → 73% 가 헤드라인이다. HWM도 네 환경 모두에서 LeWM보다 평균 성공률이 높아, 시간 분해만으로도 이득이 있음을 보여준다. 하지만 AntMaze에서 3레벨 H-JEPA는 HWM의 거의 두 배에 달해, 별도의 추상 잠재 공간이 시간 분해 이상의 것을 준다는 것을 시사한다.
Push-T의 3레벨 이상 붕괴는 데이터 때문으로 보인다. 학습 클립은 한 에피소드 안에 들어가야 하는데, 3레벨 모델의 최소 클립 길이는 61 환경 스텝, 4레벨은 121스텝이다. 에피소드가 평균 125스텝으로 짧은 Push-T는 3레벨에서 LeWM 대비 58%, 4레벨에서 14% 의 전이만 학습에 쓸 수 있다(다른 환경은 3레벨에서 75~88% 유지). 시간 스케일이 커질수록 더 긴 궤적이 필요하다는 현실적인 제약이다.
어디서 이득이 오는가: 비용 공간 vs 시간 분해
저자들은 두 효과를 분리하는 깔끔한 ablation을 한다. 레벨 1 동역학만으로 flat 계획을 하되, 목표 비용을 재는 잠재 공간만 상위 레벨로 바꾸는 것이다(예측과 목표를 로 투영한 뒤 거리 계산). AntMaze 결과(%):
| 비용 공간 \ 모델 | 2레벨 모델 | 3레벨 모델 | 4레벨 모델 |
|---|---|---|---|
| 레벨 1 (native) | 23.3 | 16.7 | 10.0 |
| 레벨 2 투영 | 31.3 | 20.7 | 20.7 |
| 레벨 3 투영 | – | 22.0 | 21.3 |
| 레벨 4 투영 | – | – | 26.7 |
| 전체 계층 계획 | 39.3 | 73.3 | 63.3 |
상위 레벨 플래너를 전혀 돌리지 않고 비용만 추상 공간에서 재도 성공률이 오르고, 모든 깊이에서 LeWM(18.0%)을 넘는다. 다만 선택적 추상화가 없는 Push-T와 Cube에서는 투영 비용이 도움이 안 되거나(Cube에서는 레벨 3·4 투영이 성공률을 절반 가까이 깎는다) 차이가 없다.
시간 분해의 효과는 비용의 단조성으로 확인한다. 전문가 궤적을 따라갈 때 flat 플래너의 전체 horizon 목표 비용은 중간에 멈추거나 오히려 올라가지만, 레벨 2 서브골을 추적하는 레벨 1 비용은 구간마다 꾸준히 내려간다. 비용과 시간의 음의 Spearman 상관으로 재면 서브골 추적은 0.891.00, 전체 horizon 목표 비용은 0.480.75다. 서브골은 더 짧은 horizon에서 더 일관된 진행 신호를 주고, 롤아웃 스텝 수도 줄여 계산을 아낀다.
🤖 DROID: 장면이 매번 바뀌는 실제 로봇 영상
마지막으로 DROID(74,530 에피소드, 3개 카메라, 256×256, 7차원 엔드이펙터 명령)로 간다. 시뮬레이터가 없으므로 계획은 오프라인·개루프로 평가한다. 집기-놓기 클립 16개를 고정하고, 5 fps에서 36스텝(약 7.2초) 계획을 뽑아 엔드이펙터의 3D 경로가 전문가 경로와 얼마나 닮았는지를 Fréchet fidelity 로 잰다. 0%는 팔이 안 움직인 것, 100%는 전문가 경로, 음수는 가만히 있는 것보다 나쁜 계획이다.
왜 inverse dynamics가 필요한가
여기서 새로운 문제가 생긴다. 시뮬레이션에서는 배경이 고정이라 예측할 것이 에이전트뿐이었지만, DROID는 장면·조명·물체가 에피소드마다 바뀐다. 그러면 순수 예측 손실 입장에서 가장 예측하기 쉬운 것은 "에피소드 내내 변하지 않는 장면 정체성"이고, 행동이 있어야만 예측되는 로봇 팔은 버리는 쪽이 유리해진다. 저자들은 이를 slow-feature collapse 라 부르고, 부록 L에서 SIGReg나 VICReg처럼 임베딩의 주변 분포(marginal law)만 보는 정규화는 이 해를 원리적으로 배제할 수 없음을 보인다. 장면 ID를 가우시안으로 흩뿌려 놓기만 하면 정규화와 예측 손실을 동시에 0으로 만들 수 있기 때문이다. 실제로 잠재 분산 중 에피소드 간 분산의 비율이 Cube는 28%인데 DROID는 75%다.
해법은 시간축의 결합 분포에 작용하는 손실, 즉 연속한 두 상태 표현에서 그 사이의 행동을 회귀하는 inverse dynamics(IDM) 항이다.
팔의 움직임을 복원하려면 두 상태가 팔 정보를 담아야 하므로 collapse가 막힌다. 레벨 2에서는 타깃이 학습된 매크로 행동이라 stop-gradient로 떼어낸다. 부록 K의 그리드 실험이 역할 분담을 잘 보여준다. SIGReg를 끄면 IDM 가중치와 무관하게 표현의 유효 랭크가 384 중 1~14로 무너지고, SIGReg를 켜면 랭크는 유지되지만 IDM이 없으면 계획 성능은 여전히 바닥이다. 둘을 함께 써야 하고, 계수도 함께 맞춰야 한다(레벨 1: SIGReg 0.08, IDM 100; 레벨 2: 0.16, 50). 예측 타깃 detachment는 결과를 바꾸지 않아 쓰지 않았다.
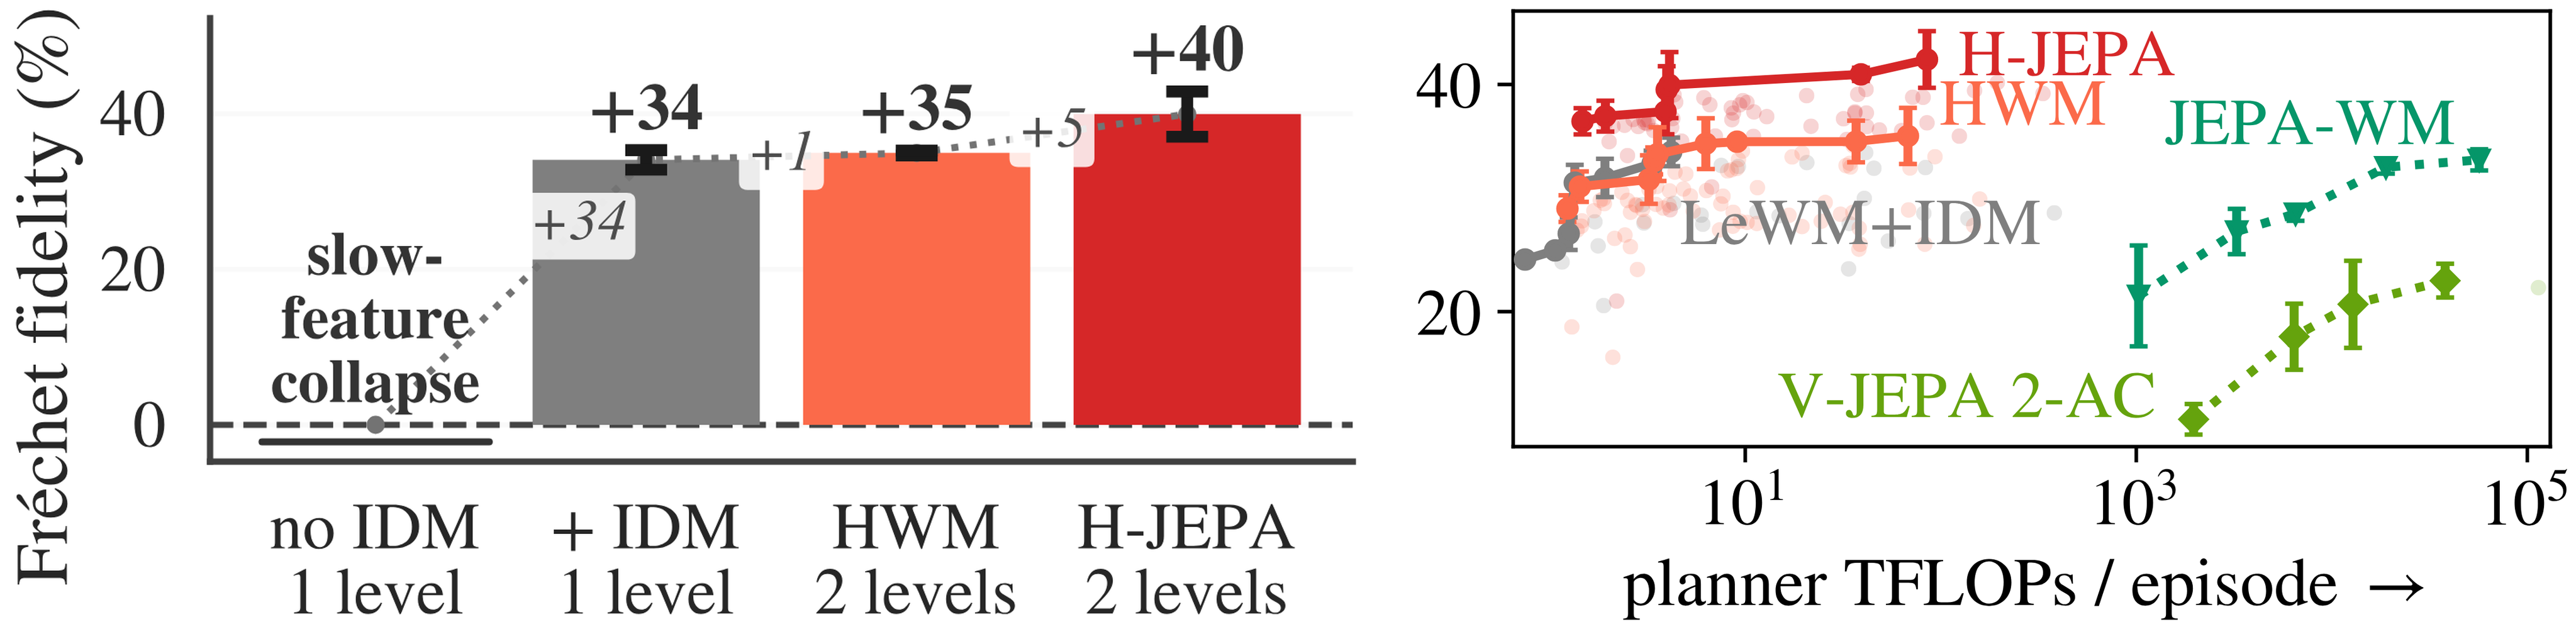
결과는 시뮬레이션과 같은 방향이다. IDM을 더한 LeWM(34%)이 이미 강한 기준선이고, 같은 잠재 공간을 쓰는 HWM은 +1에 그치지만 레벨 2 인코더를 학습한 H-JEPA는 40% 로 올라간다. Pareto 곡선에서도 H-JEPA는 더 적은 플래너 계산으로 더 높은 fidelity에 도달한다. 참고로 그린 frozen-encoder 월드 모델들(JEPA-WM, V-JEPA 2-AC)은 수 자릿수 더 많은 계산을 쓰고도 더 낮은 fidelity를 보인다. 다만 DROID에서 선택적 추상화 자체는 약하므로(주파수 비 1.2~1.6배), 여기서의 이득은 추상화보다 시간 분해와 비용 기하 쪽에서 오는 것으로 보인다.
학습은 H200 GPU에서 이루어졌고, DROID 모델은 배치 256, 에폭당 292 iteration으로 100 에폭을 돌린다. 원본 DROID는 약 5.5 TB라 H.264 디코딩이 병목이 되므로, 저자들은 256×256으로 재인코딩한 127.6 GB 사본(약 45배 축소, 디코딩 17.9배 빠름)을 만들어 공개했다.
💡 정리와 한계
H-JEPA의 메시지는 세 줄로 요약된다.
- 레벨마다 잠재 공간을 따로 두면 상위 레벨은 자기 horizon에서 예측 불가능한 빠른 세부를 버리고 느린 구조만 남긴다. 그 공간에서 잰 목표 거리는 flat 플래너에게도 더 좋은 비용이 된다.
- 시간 분해는 긴 과제를 짧은 서브골 문제로 쪼개 비용을 단조롭게 만들고 계산을 줄인다. 이건 단일 잠재 공간의 HWM도 누리는 이득이다.
- 둘을 합친 top-down 계획이 AntMaze 18%→73%, FourRoom 41%→96%, Cube 32%→60%를 만들고, DROID에서도 더 적은 계산으로 더 높은 fidelity를 낸다.
솔직한 한계도 논문에 적혀 있다. 선택적 추상화는 데이터에 시간 스케일의 분리가 있을 때만 나타나고, 그게 없는 Push-T·Cube에서는 상위 비용이 도움이 안 된다. 깊은 계층은 긴 에피소드를 요구해 Push-T에서는 3레벨부터 무너진다. DROID 결과는 전부 오프라인 지표라, 저자들도 Fréchet fidelity의 차이는 "어느 플래너가 낫다"의 증거이지 "얼마나 낫다"의 척도는 아니라고 선을 긋는다. 실제 로봇에서의 폐루프 제어는 다음 단계로 남겼다. 또 IDM 항은 행동 라벨이 있어야 하므로, 행동 없는 비디오로 확장하려면 slow-feature collapse를 막을 다른 장치가 필요하다(부록 L은 시간축 반발 항만으로는 부족하다고 본다). 카메라도 한 번에 한 대만 쓰고 손목 카메라는 아예 안 썼다.
부록의 작은 실험 하나가 눈에 띈다. 레벨 1을 먼저 학습해 얼어붙이고 레벨 2를 따로 학습하는 stagewise 방식에서, 레벨 1은 탐색 데이터(explore), 레벨 2는 목표 지향 데이터(stitch) 로 학습한 조합이 AntMaze 67%로 모든 end-to-end 조합(최고 54%)을 넘었다. 저수준 동역학은 넓은 탐색을, 추상 레벨은 시간적으로 일관된 궤적을 원한다는 것인데, 레벨마다 다른 데이터를 먹이는 설계가 다음 질문이 될 것으로 보인다.
📚 참고
- 논문: H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning (arXiv 2610.06805)
- 프로젝트 페이지: https://h-jepa.com/
- 코드: https://github.com/kevinghst/H-JEPA
- LeWM(레벨 1 베이스라인) 및 LeJEPA/SIGReg: Balestriero & LeCun, LeJEPA (arXiv 2511.08544)
- HWM: Zhang et al., Hierarchical Planning with Latent World Models (arXiv 2604.03208)
본 글의 그림은 원문에서 가져왔습니다.