UCCI: 토큰 마진을 캘리브레이션해 비용 최적 LLM 캐스케이드를 만들다
"캐스케이드 엔지니어링의 가치는 대부분 임계값을 손으로 맞추는 데서가 아니라, 라우팅 점수를 확률로 만드는 데서 나온다."
2026년 5월, 독립 연구자 Varun Kotte가 UCCI: Calibrated Uncertainty for Cost-Optimal LLM Cascade Routing(arXiv 2605.18796)을 올렸다. 주제는 익숙하다. 쉬운 질의는 작은 모델이 처리하고, 어려운 질의만 큰 모델로 넘기는 LLM 캐스케이드다. 다른 점은 접근법이다. 저자는 캐스케이드를 "임계값 튜닝 문제"가 아니라 "캘리브레이션된 결정 문제" 로 보자고 한다. 작은 모델의 토큰 수준 신호를 먼저 오류 확률로 바꾸고, 그 확률 위에서 비용을 최소화하는 임계값을 고르면 된다는 것이다. 코드는 github.com/varunkotte6/ucci에 공개되어 있다(원본 쿼리 데이터는 비공개).
이 블로그에서 다룬 Jev 글의 마지막 질문이 "캐스케이드가 작동하려면 싼 판정자가 자기 오류를 알아야 한다"였다. UCCI는 바로 그 "자기 오류를 아는" 부분을 어떻게 만드는지에 집중한 논문이다.
원문: https://arxiv.org/abs/2605.18796
🤔 배경: 캐스케이드의 병목은 라우팅 신호다
캐스케이드의 약속은 단순하다. 큰 모델 하나로 전부 처리하는 것보다 싸면서, 작은 모델 하나로 처리하는 것보다 정확하자. 하지만 논문은 이 약속과 실제 프로덕션 사이에 간극이 있다고 지적한다. 원인은 라우팅 신호다. 토큰 엔트로피나 토큰 마진 같은 LLM confidence 점수는 대개 캘리브레이션되어 있지 않고 프롬프트 문구에 민감하다. 그래서 한 워크로드에서 잘 맞던 임계값이 다른 워크로드에서는 틀어지고, 실무자는 배포마다 손으로 다시 튜닝한다.
이 문제는 사실 ML에서 오래된 selective prediction 문제의 변형이다. 모델이 자신 없는 입력에 대해 답을 거부(abstain)하거나 전문가에게 넘기는(defer) 문제로, 여기서는 "전문가"가 큰 모델이다. 핵심 개념은 risk–coverage 트레이드오프 다. coverage는 작은 모델이 직접 답하는 비율, risk는 그 답들의 오류율이다. coverage를 올리면(더 많이 직접 답하면) 비용은 내려가지만 risk는 올라간다. 캐스케이드 설계란 결국 이 곡선 위에서 "정확도 목표를 만족하는 가장 싼 점"을 고르는 일이다.
저자는 기존 selective classification 프레임워크가 분류 헤드의 스칼라 confidence를 전제한다는 점을 짚고, LLM 구조화 출력에 적용하려면 세 가지가 더 필요하다고 정리한다.
- 불확실성을 토큰 수준 생성에서 집계해야 한다.
- 원시 토큰 confidence는 미캘리브레이션 상태라 명시적 보정이 필요하다.
- 전체 정확도로 시뮬레이션한 라우팅이 아니라, 실제 모델 출력으로 end-to-end 측정해야 한다.
🧠 핵심 아이디어: 먼저 캘리브레이션하고, 그 다음에 임계값
문제를 수식으로 적으면 이렇다. 작은 모델 와 큰 모델 , 질의당 비용 , 정확도 지표 (논문은 micro-F1)가 있을 때, 라우팅 정책 에 대해
를 푼다. 목표 정확도 는 작은 모델 단독 정확도 와 큰 모델 단독 정확도 사이에서 고른다.
UCCI는 이걸 세 단계로 푼다.
- 불확실성 추출: 작은 모델의 생성 과정에서 스칼라 점수 를 뽑는다.
- 캘리브레이션: 를 오류 확률 로 바꾼다.
- 임계값 선택: 검증 세트에서 정확도 제약을 만족하며 비용을 최소화하는 를 고른다.
논문의 한 줄 요약은 "calibrating first and thresholding second"다. 원시 토큰 마진은 그대로 쓰면 약한 신호지만, held-out 세트에서 작은 isotonic fit 한 번을 거치면 저자들 설정에서는 거의 최적에 가까운 라우팅 점수 가 된다는 것이다.
📐 방법 상세
1) 토큰 마진 집계
greedy decoding으로 생성한 시퀀스의 각 위치 에서 top-1 확률 과 top-2 확률 를 읽는다. 둘의 차이가 토큰 마진 이고, 이를 시퀀스 전체에 평균 내서 뒤집은 것이 불확실성 점수다.
가 클수록 불확실하다. greedy decoding을 고집하는 이유는 위치마다 가 잘 정의되게 하기 위해서다.
저자는 세 가지 신호(토큰 마진, 예측 엔트로피, max probability)를 비교했고 토큰 마진이 가장 좋은 비용-정확도 곡선 을 냈다고 보고한다. 해석이 흥미롭다. 구조화된 JSON 출력에서는 결정적인 판단이 소수의 고정보 토큰(예: 엔티티 값이 들어가는 자리)에 몰려 있다. 그 자리에서 "1등 후보와 2등 후보가 얼마나 붙어 있나"를 보는 top-2 마진이, 어휘 전체에 퍼진 확률 질량까지 합산하는 엔트로피보다 국소적 모호함을 더 잘 잡는다 는 것이다. 자유 생성에서 강력한 semantic entropy는 쓰지 않았는데, JSON 추출은 증거가 소수 스키마 토큰에 집중되는 데다 semantic entropy는 여러 샘플이나 의미 클러스터링이 필요해 서빙 비용 모델 자체를 바꾸기 때문이다.
2) Isotonic regression으로 오류 확률 만들기
캘리브레이션을 위해 이진 정답 이벤트를 정의한다. 은 작은 모델의 JSON 출력이 모든 엔티티 필드에서 정답과 정확히 일치하지 않는 경우다(평가 지표는 micro-F1이지만, 캘리브레이션 맵을 맞출 때만 이 이진 이벤트를 쓴다). 그리고 단조 증가 함수 를 학습한다.
는 캘리브레이션 세트 위에서 isotonic regression 으로 맞춘다. isotonic regression은 "입력이 커지면 출력도 커진다"는 단조성 제약만 두고 계단 모양의 함수를 자유롭게 맞추는 비모수 방법이다. 논문의 ablation에 따르면 같은 캘리브레이션 세트에서 ECE가 isotonic 0.03, temperature scaling 0.08, 미보정 0.12였다. temperature scaling은 파라미터 하나짜리 단조 리스케일링이라 이 워크로드에서 토큰 마진의 미캘리브레이션 모양을 교정하기에 너무 경직되어 있고, isotonic regression이 맞는 귀납 편향을 가졌다는 설명이다.
3) 비용 제약 하의 임계값 선택
캘리브레이션된 오류 확률 위에서 정책은 단순한 임계값이다.
두 모델을 모두 돌려 둔 검증 세트 에서 실제 비용과 실제 모델 출력으로 와 를 계산하고,
를 고른다.
왜 임계값이면 충분한가 (Theorem 1)
논문의 첫 번째 이론 결과는 "이 임계값 정책이 비용 최적"이라는 것이다. 가정은 세 가지다. (i) , (ii) 큰 모델의 정확도 은 어떤 질의가 넘어오든 변하지 않는다, (iii) 진짜 캘리브레이션된 에 접근할 수 있다.
증명의 직관은 greedy다. 질의 를 큰 모델로 넘기면 작은 모델의 기대 정확도 가 고정값 로 바뀌고, 추가 비용은 항상 로 같다. 즉 비용 단위당 정확도 이득
는 에 대해 단조 증가한다. 그러니 가 큰 질의부터 차례로 넘기다가 정확도 제약이 만족되는 순간 멈추는 것이 최적이고, 가 단조이므로 이는 곧 에 대한 임계값이다. isotonic regression은 계단 함수를 내놓으므로 값이 같은 질의들이 뭉치는데(atoms), 그 안에서 누구를 넘기든 기대 비용과 정확도는 같아서 tie-breaking을 제외하면 최적 정책은 유일하다.
두 번째 결과(Proposition 2)는 캘리브레이션 표본 복잡도다. isotonic regression의 MSE 수렴률 (Barlow et al., 1972)에 Cauchy–Schwarz를 적용하면 ECE는 로 줄어든다. 수렴이 빠른 편은 아니지만, 라벨이 있는 캘리브레이션 세트가 수만 개 규모라면 충분히 작아진다는 뜻으로 읽힌다.
📊 실험 결과
설정
- 과제: 엔터프라이즈 사진 관리 시스템의 프로덕션 NER. 자연어 검색 질의에서 최대 6개 엔티티(camera, lens, aperture, shutter speed, ISO, focal length)를 JSON으로 추출. 수동 라벨 75,000건, 평균 6.2단어, 89%가 엔티티를 하나 이상 포함.
- 분할: 캘리브레이션 22,500(30%) / 검증 15,000(20%) / 테스트 37,500(50%).
- 모델: 4B 인스트럭션 튜닝 LLM(small)과 12B(large). 동일 프롬프트, greedy decoding, vLLM 0.4.2, H100 80GB.
- 비용: 명목 API 가격이 아니라 H100에서 측정한 end-to-end 지연 이다. cold cache 100질의 평균으로 small 47.2±3.1 ms, large 142.3±8.7 ms, 비율 . 정규화해서 , 로 보고한다.
- 평가 방식: 캘리브레이션 세트에서 를 맞추고, 검증 세트에서 를 고른 뒤, 테스트 질의마다 를 계산해 실제 또는 의 출력 을 선택하고 실제 비용·정확도를 누적한다. 전체 정확도로 라우팅 결과를 시뮬레이션하는 평가가 갖는 선택 편향을 없애기 위해서다.
- 베이스라인: 항상 small / 항상 large, 미보정 평균 토큰 엔트로피 임계값, split conformal prediction(원시 를 nonconformity score로 사용), FrugalGPT 스타일 학습 임계값. RouteLLM과 Hybrid LLM은 선호/품질 격차 라벨이 필요해 이 워크로드에서는 돌리지 못했다.
| 모델 | Micro F1 | 비용 |
|---|---|---|
| Small (4B) | 0.847 | 1.00 |
| Large (12B) | 0.932 | 3.02 |
12B가 4B보다 8.5 F1 포인트 높고 비용은 3배다. 선택적 라우팅이 끼어들 여지가 있는 구간이다.
캘리브레이션 품질
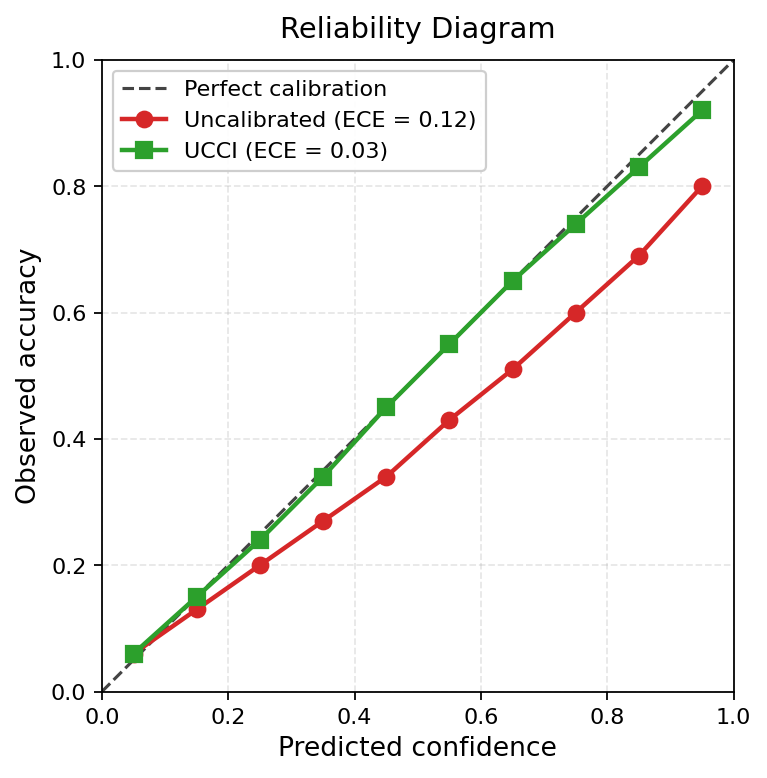
그림 1이 reliability diagram이다. 미보정 토큰 마진(빨강)은 전 구간에서 대각선 아래에 있다. 즉 모델이 말하는 confidence보다 실제 정확도가 낮은 과신(overconfidence) 상태고, confidence 0.95 구간에서 실제 정확도는 0.80 정도다. isotonic regression을 거친 UCCI(초록)는 전 구간에서 대각선을 따라간다. ECE는 0.12에서 0.03(부트스트랩 95% CI [0.02, 0.04])으로 줄었다.
비용-정확도 트레이드오프
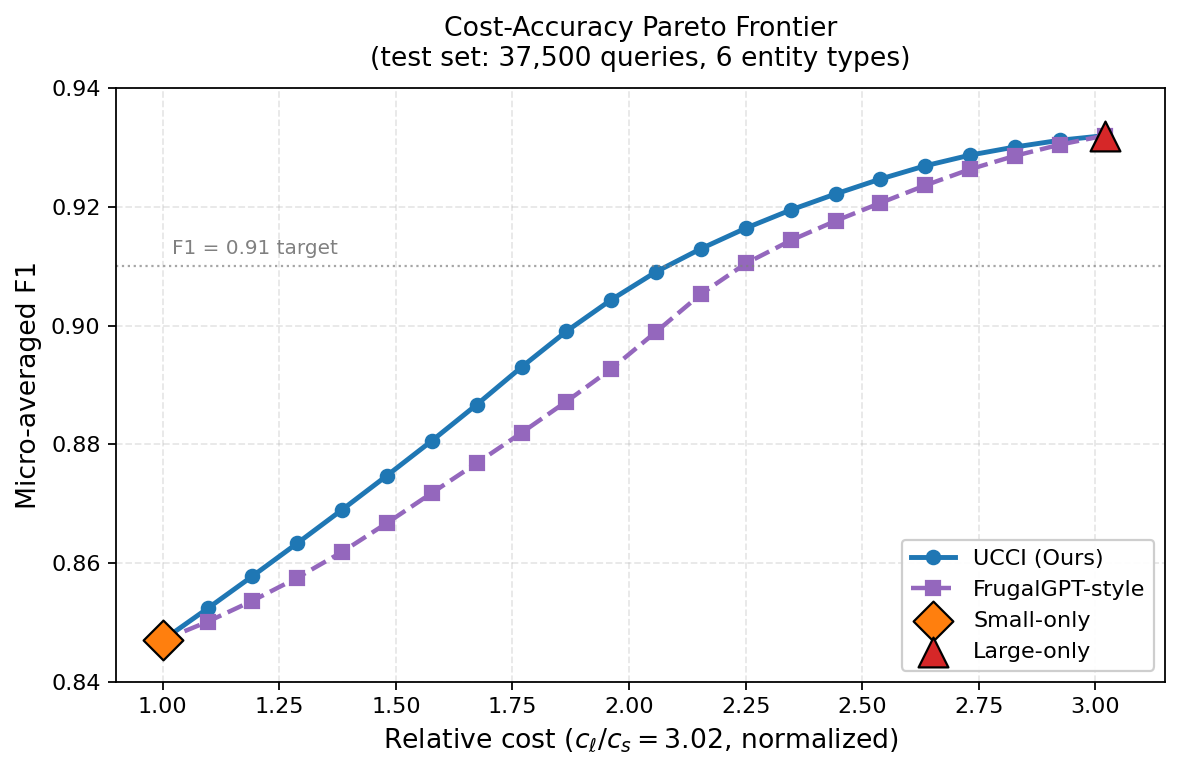
그림 2가 핵심 결과다. small-only(비용 1.0, F1 0.847)에서 large-only(3.02, 0.932)까지 이어지는 곡선에서 UCCI(파랑)가 FrugalGPT 스타일(보라) 위에 있다. 눈여겨볼 건 곡선의 모양 이다. 두 곡선 모두 중간 구간에서 가파르고 양 끝에서 완만한데, UCCI는 그 가파른 구간에서 더 일찍 올라간다. 캘리브레이션이 잘 되어 있으면 "넘겼을 때 이득이 큰 질의"부터 정확히 집어내므로 같은 비용에 더 많은 F1을 산다는 뜻이다.
F1 = 0.91 목표에서 UCCI 비용은 2.08, large-only 3.02 대비 31% 절감(부트스트랩 95% CI [27%, 35%])이다. 같은 운영점에서 다른 방법과 비교하면 다음과 같다.
| 방법 (F1 = 0.91 기준) | 비용 | UCCI 대비 |
|---|---|---|
| UCCI | 2.08 | – |
| Conformal prediction | 2.18 | +5% |
| FrugalGPT-style | 2.24 | +8% |
| Entropy threshold | 2.31 | +11% |
| Large-only | 3.02 | (F1 +0.02) |
| Small-only | 1.00 | (F1 −0.06) |
비용을 2.00으로 고정하면 UCCI는 목표 F1을 0.01 넘고, 엔트로피 임계값은 0.02 못 미친다.
비용 비율과 엔티티별 격차
같은 라우팅 결정을 가상의 비용 비율에 적용하면 절감률이 더 커진다. 모든 escalation의 한계 비용이 동일하므로 정확도 제약을 만족하는 임계값은 그대로고, 비용 스케일만 바뀌기 때문이다.
| UCCI 비용 | large-only 대비 절감 | |
|---|---|---|
| 3.02 | 2.08 | 31% |
| 5.00 | 3.14 | 37% |
| 10.00 | 5.81 | 42% |
엔티티별로 보면 적응형 라우팅이 왜 필요한지 보인다.
| 엔티티 | Small | Large | 격차 |
|---|---|---|---|
| Camera | 0.71 | 0.89 | 18.0 |
| Lens | 0.68 | 0.86 | 18.0 |
| Aperture | 0.93 | 0.96 | 3.0 |
| Shutter speed | 0.91 | 0.95 | 4.0 |
| ISO | 0.92 | 0.95 | 3.0 |
| Focal length | 0.96 | 0.98 | 2.0 |
작은 모델은 숫자형 필드(조리개, 셔터 속도, ISO, 초점 거리)는 거의 큰 모델만큼 잘 뽑지만, camera와 lens 같은 고유명사 엔티티 에서는 크게 뒤처진다. 단일한 전역 정확도 격차가 없으니, 고정 비율로 일부를 무작위 escalation하는 식의 정책으로는 이 이질성을 잡을 수 없다. (본문은 lens 격차를 14.3 포인트, focal length를 1.8 포인트로 서술하는데 표의 수치와 약간 다르다. 표에 적힌 값을 그대로 옮겼다.)
🔍 캘리브레이션이 깨지는 조건
이 논문에서 가장 읽을 만한 부분은 저자가 자기 방법이 언제 무너지는지 를 명시적으로 적어 둔 대목이다.
가정 (ii): 큰 모델 정확도가 라우팅과 무관해야 한다
Theorem 1의 세 가정 중 가장 제한적인 것이다. 넘어오는 질의가 체계적으로 더 어렵다면, escalation된 부분집합에서 큰 모델의 정확도는 전체 평균 보다 낮아진다. 저자는 이를 직접 쟀다. F1 = 0.91 운영점에서 큰 모델은 escalation된 질의에서 micro-F1 0.928, 전체 테스트 세트에서 0.932로 차이가 0.004 에 불과했다. 이 워크로드에서는 가정이 근사적으로 성립한다.
하지만 작은 모델이 어려워하는 질의가 큰 모델에게도 어려운 도메인이라면 이 가정은 깨진다. 그러면 임계값 정책은 전역 최적이라는 보장을 잃고 "캘리브레이션된 휴리스틱"으로 남는다(다만 엔트로피, conformal, FrugalGPT 대비 실험 비교 자체는 영향받지 않는다). 이 지점이 Jev 글에서 Penn 논문이 캐스케이드가 안 된다고 결론 내린 이유와 정확히 겹친다. 거기서는 싼 판정자와 LLM 판정자의 오류가 상관되어 있어, 넘겨도 큰 모델이 같은 곳에서 틀렸다. UCCI의 NER 워크로드는 그 반대 경우로 보인다. 작은 모델의 오류 상당수는 큰 모델이 고칠 수 있는 종류였다.
무거운 꼬리(heavy-tailed) 마진
두 번째 실패 조건은 가 질의별 오류율에 대해 정보가 없는 경우다. 토큰 마진 분포의 꼬리가 무거우면, 일부 질의는 가 분포의 몸통에 있으면서도 실제 오류 확률은 매우 높을 수 있다. 유한 표본의 캘리브레이션은 이걸 교정하지 못하고, 임계값 라우팅은 오라클보다 이런 질의를 덜 넘긴다. 저자는 이 워크로드의 마진 꼬리 통계를 직접 측정하지는 않았다고 밝힌다. 다만 UCCI와 오라클 사이 잔여 비용 격차가 camera와 lens에 집중되어 있어 heavy-tail 가설과 부합하지만 입증은 아니라고 조심스럽게 적는다. 마진 꼬리가 더 무거운 워크로드에서는 엔트로피 대비 상대 이득은 유지되더라도 절대 절감폭은 줄어들 것으로 본다.
정적 캘리브레이션과 분포 이동
는 held-out 배치 하나로 한 번 맞춘다. 스트리밍 환경에서 분포가 바뀌면 온라인·지속 재캘리브레이션이 필요하다. 임계값 프레임워크는 그대로 쓸 수 있지만 피팅 절차를 바꿔야 한다.
Conformal prediction과의 관계
베이스라인 중 하나인 split conformal routing은 이 블로그의 Conformal Prediction 글에서 다룬 방식 그대로다. "작은 모델이 맞다"는 이진 이벤트에 대해 원시 를 nonconformity score로 쓰고, 검증 세트에서 miscoverage를 통제하는 를 골라 인 질의를 넘긴다. 분포에 무관한 coverage 보장이 장점이지만, 이 실험에서는 UCCI보다 5% 비용이 더 들었다. 두 방법의 차이를 한 줄로 요약하면, conformal은 coverage를 보장하는 분위수 임계값 을 고르고 UCCI는 오류 확률을 복원한 뒤 비용 최적 임계값 을 고른다. 보장이 필요하면 전자, 비용을 짜내야 하면 후자라는 식으로 읽을 수 있다. 다만 저자는 베이스라인의 독립성을 위해 conformal에 캘리브레이션된 가 아닌 원시 를 썼다고 명시했으므로, "캘리브레이션 후 conformal"은 비교되지 않았다.
💡 정리와 열린 질문
UCCI의 기여를 정리하면 이렇다.
- 캐스케이드를 제약 최적화로 정식화하고, 세 가정 하에서 캘리브레이션된 오류 확률의 임계값 정책이 비용 최적임을 증명했다.
- 토큰 마진 평균 + isotonic regression 으로 ECE를 0.12에서 0.03으로 낮췄다. temperature scaling(0.08)보다 좋았다.
- 75,000건 프로덕션 NER에서 F1 0.91 기준 비용 31% 절감. 모두 실제 모델 출력과 측정된 H100 지연 기준이다.
- 같은 운영점에서 엔트로피(2.31), conformal(2.18), FrugalGPT 스타일(2.24)보다 쌌다.
한계도 분명하다. 단일 도메인(사진 NER), 단일 모델 쌍(4B/12B), 단일 언어다. 31%나 0.03 같은 절대 수치는 워크로드 종속적이고, 저자도 CoNLL-2003 같은 공개 벤치마크와 다른 모델 패밀리로 재현하는 것을 다음 단계로 꼽는다. RouterBench는 이종 과제 API 라우팅을 겨냥하므로 비교하지 않았다. 비용도 H100 지연 하나로 쟀는데, 달러 비용·처리량·에너지·배칭 하 사용자 지연으로 바꾸면 을 다시 유도해야 한다(캘리브레이션 단계와 최적성 논증은 바뀌지 않는다).
읽고 나서 남는 질문은 이런 것들이다.
- 자유 생성에서도 토큰 마진이 통할까. 저자 스스로 "구조화 JSON은 증거가 소수 스키마 토큰에 집중된다"를 마진이 이긴 이유로 들었다. 긴 자유 응답에서는 그 전제가 약해지고, 평균 대신 최소 마진이나 특정 토큰 가중 같은 다른 집계가 필요할 수 있다.
- 3단 이상 캐스케이드와 큰 모델의 불확실성. 이 논문은 두 모델, 그리고 작은 모델의 신호만 쓴다. 큰 모델도 abstain할 수 있는 설정(Zellinger et al., 2025)은 관련 연구로만 언급된다.
- 캘리브레이션된 점수 위의 conformal. 보장과 비용 최적성을 동시에 가져갈 수 있는지는 비교되지 않았다.
"임계값 튜닝이 아니라 캘리브레이션이 엔지니어링할 가치가 있는 부분"이라는 결론은, 캐스케이드를 운영 중이면서 임계값을 워크로드마다 손으로 맞추고 있는 팀에게 꽤 실용적인 메시지다. isotonic regression 한 번은 거의 공짜에 가깝다.
📚 참고
- 원문: UCCI: Calibrated Uncertainty for Cost-Optimal LLM Cascade Routing (Varun Kotte, arXiv 2605.18796, 2026.05) · HTML 버전
- 코드: github.com/varunkotte6/ucci
- FrugalGPT: How to use large language models while reducing cost and improving performance (Chen, Zaharia, Zou, 2023)
- Selective classification: Geifman & El-Yaniv, Selective classification for deep neural networks (NeurIPS 2017)
- Isotonic calibration: Zadrozny & Elkan, Transforming classifier scores into accurate multiclass probability estimates (KDD 2002)
- Conformal prediction: A gentle introduction to conformal prediction (Angelopoulos & Bates, 2021)
- 캘리브레이션: Guo et al., On calibration of modern neural networks (ICML 2017)
- 블로그 내 관련 글: Jev: System One 결정 모델, Conformal Prediction
본 글의 그림은 원문에서 가져왔습니다.