스트리밍 ASR 2026: 음성 인코더 + LLM 디코더가 음성 인식을 평정하다
"음성 인식은 더 이상 '음향 패턴 매칭'이 아니다. 오디오를 먼저 이해하고, 그 이해를 조건으로 텍스트를 생성한다." — Qwen3-ASR 기술 보고서의 문제 의식을 요약하면 이렇다.
2026년 10월 1일, Microsoft AI(MAI)가 첫 스트리밍 전사 모델 MAI-Transcribe-2-Streaming 을 공개하면서 "Artificial Analysis 스트리밍 리더보드 1위"를 내걸었다. 같은 해 1월 29일에는 Alibaba Qwen 팀이 Qwen3-ASR(0.6B / 1.7B)과 LLM 기반 강제 정렬 모델 Qwen3-ForcedAligner-0.6B 를 Apache 2.0으로 풀었다. 두 모델은 공개 방식이 정반대다. 한쪽은 기술 보고서가 없고 API만 있으며, 다른 한쪽은 가중치·코드·보고서가 전부 있다. 그래서 이 글은 둘을 같은 잣대로 보기 위해 벤더 주장과 독립 측정치, 1차 자료에서 확인된 사실을 구분해서 정리한다.
이 블로그에서는 올해 초 NVIDIA Nemotron Speech Streaming ASR 글에서 FastConformer + RNN-T 기반의 캐시 인식 스트리밍을, 작년에는 Meta Omnilingual ASR 글에서 wav2vec 2.0 인코더 + 트랜스포머 디코더 조합을 다뤘다. 이번 글은 그 두 글의 2026년 업데이트 에 해당한다.
원문: Microsoft 발표 · Qwen3-ASR Technical Report (arXiv:2601.21337) · Qwen3-ASR GitHub · Artificial Analysis Speech to Text (Streaming)
🤔 배경: CTC/RNN-T/AED에서 "LALM" 패러다임으로
Qwen3-ASR 보고서 서론은 최근 ASR의 흐름을 한 문장으로 정리한다. Transducer(RNN-T)와 AED 같은 전통적 E2E 패러다임에서 Large Audio-Language Model(LALM) 패러다임으로 옮겨갔다는 것이다. 모델이 음향 패턴을 바텀업으로 맞추는 대신, 먼저 오디오에 대한 고수준 이해를 형성하고 그 이해를 조건으로 전사를 생성한다. 저자들은 이 방식이 긴 오디오 전사, 잡음 강건성, 세계 지식과 고유명사 인식, 다국어·방언 커버리지처럼 기존 ASR이 어려워하던 문제를 "더 자연스럽게" 푼다고 주장한다.
이전 Nemotron 글에서 봤듯, RNN-T는 예측 네트워크가 텍스트만 보기 때문에 스트리밍에 유리하고 디코더 그래프가 필요 없어 가볍다. 반면 LLM 디코더는 수십억 파라미터의 언어 지식을 통째로 가져오지만, 자기회귀 생성이라 첫 토큰까지의 지연(TTFT)과 확정(final) 지연 을 어떻게 줄이느냐가 스트리밍의 핵심 과제가 된다. 2026년의 두 모델은 이 과제에 각자 다른 답을 내놓는다.
🔍 먼저 검증: "다들 Conformer 인코더 + LLM 디코더"는 사실인가?
이 글의 제목 후보는 원래 "Conformer 인코더 + LLM 디코더"였다. 그런데 모델 카드와 논문을 직접 확인해 보니 절반만 맞다. 각 모델의 1차 자료에서 확인한 내용을 표로 정리한다.
| 모델 (공개 시점) | 음성 인코더 | 연결부 | LLM 디코더 | 출처 |
|---|---|---|---|---|
| NVIDIA Canary-Qwen-2.5B (2025.07) | FastConformer (canary-1b-flash에서 가져옴) | 선형 투영 + LoRA | Qwen3-1.7B | HF 모델 카드 |
| Fun-ASR (2025.09, Alibaba Tongyi) | 트랜스포머 인코더 0.7B (Best-RQ 자기지도 사전학습, Qwen3 LLM 레이어 가중치로 초기화) | 2층 트랜스포머 어댑터 + CTC 디코더 | 7B LLM 디코더 (nano: 0.2B + 0.6B) | arXiv:2509.12508 |
| Qwen3-ASR-1.7B/0.6B (2026.01) | AuT 인코더: Conv2d 다운샘플링 3층 + 셀프어텐션 32층 (300M / 180M) | 프로젝터 | Qwen3-1.7B / Qwen3-0.6B | arXiv:2601.21337 |
| FireRedASR2-LLM (2026.03) | Conformer 인코더 | 경량 어댑터 | 사전학습 텍스트 LLM (FireRedASR-LLM 계보: Qwen2-7B-Instruct) | arXiv:2603.10420, arXiv:2501.14350 |
| MAI-Transcribe-2-Streaming (2026.10) | 비공개 | 비공개 | 비공개 | 기술 보고서 없음 |
정리하면 Conformer(또는 FastConformer)를 쓰는 건 Canary-Qwen과 FireRedASR2-LLM 둘 이고, Qwen3-ASR의 AuT와 Fun-ASR의 인코더는 컨볼루션 모듈이 블록 안에 들어가는 Conformer가 아니라 순수 셀프어텐션 트랜스포머 다(AuT는 입력단 Conv2d 다운샘플링만 있다). 그래서 이 글의 제목도 "Conformer"가 아니라 "음성 인코더"로 바꿨다.
다만 공통 분모는 분명하다. 네 모델 모두 (1) 대규모로 사전학습된 0.2B0.7B급 음성 인코더, (2) 얇은 어댑터/프로젝터, (3) 사전학습된 텍스트 LLM(0.6B7B)을 디코더로 쓰는 Encoder-Adapter-LLM 구조다. 또 하나 눈에 띄는 점은 Fun-ASR이 음성 인코더 자체를 Qwen3 LLM 레이어의 가중치로 초기화 했다는 것이다. LLM의 언어 지식이 음성 표현 학습에 유익한 귀납 편향을 준다는 가설에서인데, 인코더까지 LLM화되는 흐름으로 보인다.
한 가지 주의할 점은 Canary-Qwen-2.5B는 모델 카드에 오프라인 전용, 영어 전용 으로 명시돼 있어 "스트리밍 ASR" 비교 대상은 아니라는 것이다. Fun-ASR은 스트리밍 디코딩 과정을 모사한 청크 입력 데이터를 섞어 파인튜닝하는 식으로 스트리밍을 지원하며, FireRedASR2S 논문에서 스트리밍이 명시된 모듈은 ASR이 아니라 VAD(FireRedVAD)다. MAI-Transcribe-2-Streaming은 구조를 전혀 공개하지 않았으므로, 이 모델이 LLM 디코더를 쓰는지는 확인할 수 없다.
🧠 Qwen3-ASR: AuT 인코더 + Qwen3 LM, 그리고 '동적 어텐션 윈도'
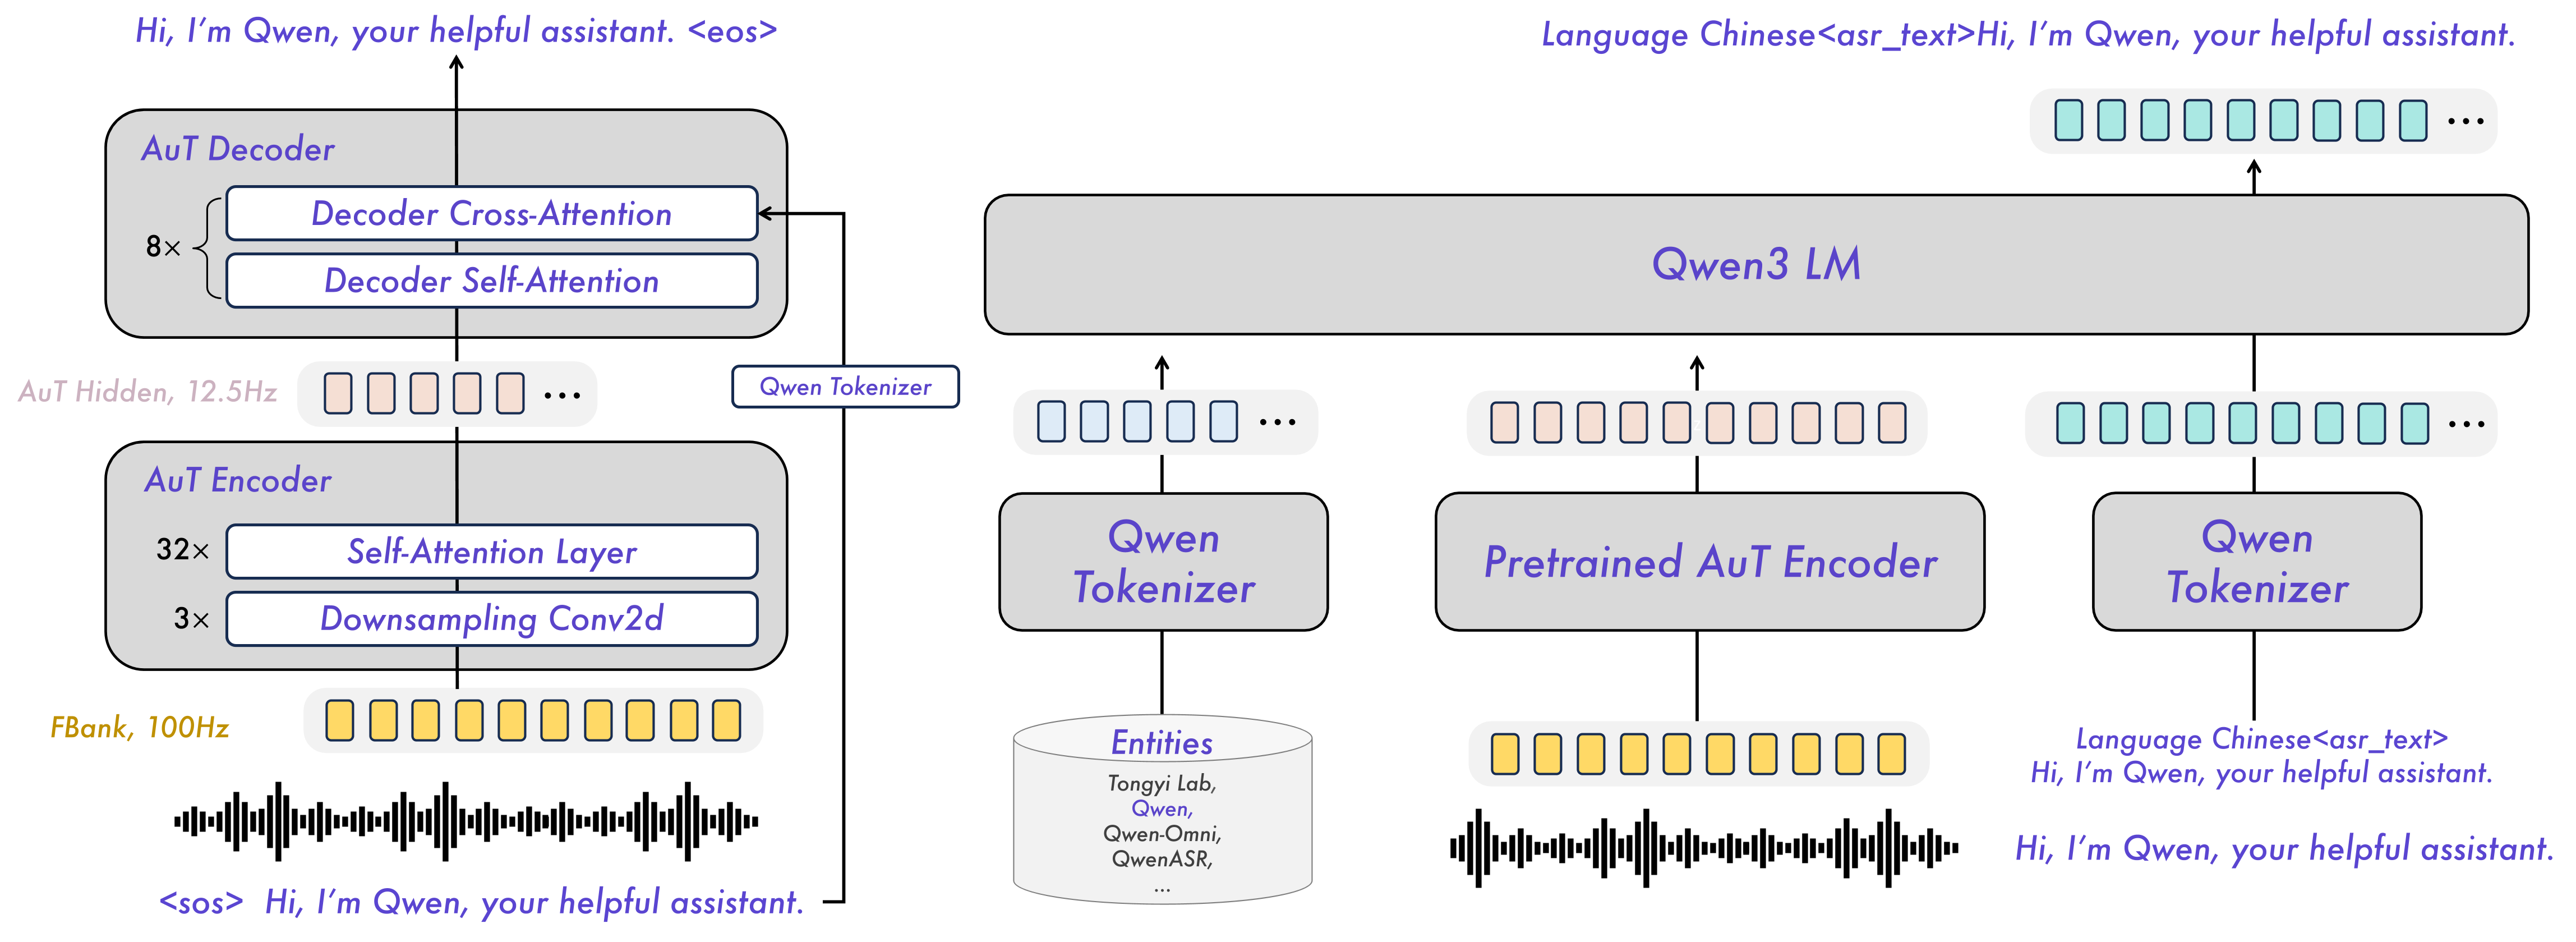
Figure 2 왼쪽이 AuT(Audio Transformer) 다. 128차원 FBank(100Hz)를 Conv2d 3층으로 8배 다운샘플링해 12.5Hz 토큰열을 만들고, 셀프어텐션 32층을 통과시킨다. 사전학습은 AED(attention encoder-decoder) 프레임워크로 하는데, 8층짜리 AuT 디코더는 사전학습용이고 Qwen3-ASR에는 인코더만 가져온다. 사전학습 데이터는 약 4,000만 시간 의 의사 레이블 ASR 데이터(대부분 중국어·영어)다.
스트리밍 관점에서 핵심은 동적 flash attention 윈도 다. 어텐션 윈도 크기를 1초~8초 범위에서 동적으로 바꿔가며 학습해, 같은 인코더가 짧은 청크의 스트리밍 추론과 긴 쿼리의 오프라인 추론을 모두 안정적으로 처리한다. Nemotron이 학습 시 여러 att_context_size를 섞어 런타임에 청크 크기를 고르게 한 것과 발상이 비슷하다.
오른쪽이 Qwen3-ASR 본체다. 두 모델의 구성은 다음과 같다.
| 모델 | AuT 인코더 | LLM | 비고 |
|---|---|---|---|
| Qwen3-ASR-1.7B | 300M (hidden 1024) | Qwen3-1.7B | 다국어·방언·복잡 환경 강건성 |
| Qwen3-ASR-0.6B | 180M (hidden 896) | Qwen3-0.6B | 1B 미만 모델 중 정확도-효율 균형 |
학습은 4단계다. (1) AuT 사전학습, (2) Qwen3-Omni 사전학습(3조 토큰의 오디오·비전·텍스트 멀티태스크, Omni와 동일), (3) ASR SFT, (4) GSPO 기반 RL(약 5만 발화, 중/영 35% + 다국어 35% + 기능 데이터 30%). 저자들은 RL이 잡음 강건성과 전사 안정성에 "필수적"이었다고 적는다. SFT 단계에는 비음성 데이터, 스트리밍 강화 데이터, 컨텍스트 바이어싱 데이터가 들어가며, 흥미롭게도 모델을 자연어 지시를 따르지 않는 ASR 전용 모델 로 학습한다. 프롬프트 인젝션과 지시 추종 실패를 막기 위해서다. 출력은 language English <asr_text> … 형식으로 언어 식별 결과를 먼저 내고, 음성이 없으면 별도 스타일로 응답한다.
지원 범위는 30개 언어 + 22개 중국어 방언 = 52개 이며, 한국어도 포함된다. 노래, BGM이 깔린 곡 전사도 지원한다.
📐 스트리밍 성능과 지연
보고서 4.5절은 2초 청크, 5토큰 fallback, 마지막 4개 청크 미확정(unfixed) 설정으로 스트리밍 WER을 측정한다.
| 모델 | 모드 | LibriSpeech (clean/other) | Fleurs-en | Fleurs-zh | 평균 |
|---|---|---|---|---|---|
| Qwen3-ASR-1.7B | 오프라인 | 1.63 / 3.38 | 3.35 | 2.41 | 2.69 |
| Qwen3-ASR-1.7B | 스트리밍 | 1.95 / 4.51 | 4.02 | 2.84 | 3.33 |
| Qwen3-ASR-0.6B | 오프라인 | 2.11 / 4.55 | 4.39 | 2.88 | 3.48 |
| Qwen3-ASR-0.6B | 스트리밍 | 2.54 / 6.27 | 5.38 | 3.40 | 4.40 |
스트리밍 전환 시 평균 WER이 1.7B는 0.64%p, 0.6B는 0.92%p 오른다. Nemotron이 1.12초 청크(7.16%)에서 80ms 청크(8.53%)로 갈 때 1.37%p 올랐던 것과 비교하면, 2초라는 꽤 긴 청크를 쓰는 대신 저하 폭은 작다. 즉 Qwen3-ASR의 스트리밍은 Nemotron의 80160ms 초저지연 모드보다는 560ms1.12초 모드에 가까운 위치 로 보인다.
지연은 vLLM v0.14.0 + CUDA Graph + bf16 기준 Table 2에 정리돼 있다. 0.6B 모델은 동시성 1에서 평균 TTFT 92ms(p95 105ms) 이고, 동시성 128에서는 "2,000초 오디오를 1초에" 처리한다. 다만 TTFT는 동시성에 따라 가파르게 오른다. 같은 표에서 동시성 8이면 평균 228ms, 32면 820ms, 128이면 3,210ms 다. 92ms는 단일 스트림 숫자라는 점을 기억해야 한다. 또 README에 따르면 스트리밍 추론은 vLLM 백엔드에서만 되고, 배치 추론과 타임스탬프 반환은 스트리밍 모드에서 지원되지 않는다.
📊 오프라인 정확도
보고서는 GPT-4o-Transcribe, Gemini-2.5-Pro, Doubao-ASR(상용 API)과 Whisper-large-v3, FunASR-MLT-Nano, GLM-ASR-Nano(오픈소스)를 베이스라인으로 삼았고, API 결과는 직접 돌려서 얻었다고 밝힌다. Table 3의 일부를 옮기면 다음과 같다(WER/CER %).
| 벤치마크 | GPT-4o-Transcribe | Whisper-large-v3 | Qwen3-ASR-0.6B | Qwen3-ASR-1.7B |
|---|---|---|---|---|
| LibriSpeech clean / other | 1.39 / 3.75 | 1.51 / 3.97 | 2.11 / 4.55 | 1.63 / 3.38 |
| Fleurs-en | 2.40 | 4.08 | 4.39 | 3.35 |
| GigaSpeech | 25.50 | 9.76 | 8.88 | 8.45 |
| WenetSpeech net / meeting | 15.30 / 32.27 | 9.86 / 19.11 | 5.97 / 6.88 | 4.97 / 5.88 |
| AISHELL-2 | 4.24 | 5.06 | 3.15 | 2.71 |
| KeSpeech (방언) | 26.87 | 28.79 | 7.08 | 5.10 |
영어 LibriSpeech clean에서는 GPT-4o-Transcribe(1.39)가 여전히 앞서지만, 중국어와 방언에서는 격차가 크게 벌어진다. 다국어(Table 5)에서는 12개 언어 Fleurs 평균 4.90(Whisper-large-v3 5.27), CommonVoice 13개 언어 9.18(Whisper 10.77)이고, 언어 식별 정확도는 평균 97.9%(Whisper 94.1%)다. 내부 벤치마크(Table 4)에서는 극한 잡음(ExtremeNoise) 16.17 대 Whisper 63.17, 22개 중국어 방언 대화 15.94 대 GPT-4o 45.37처럼 "오픈 벤치마크에서는 비슷해 보여도 실제 환경에서는 크게 갈린다"는 저자들의 주장을 뒷받침하는 숫자들이 나온다.
🕒 Qwen3-ForcedAligner: LLM으로 타임스탬프를 '한 번에' 찍는다
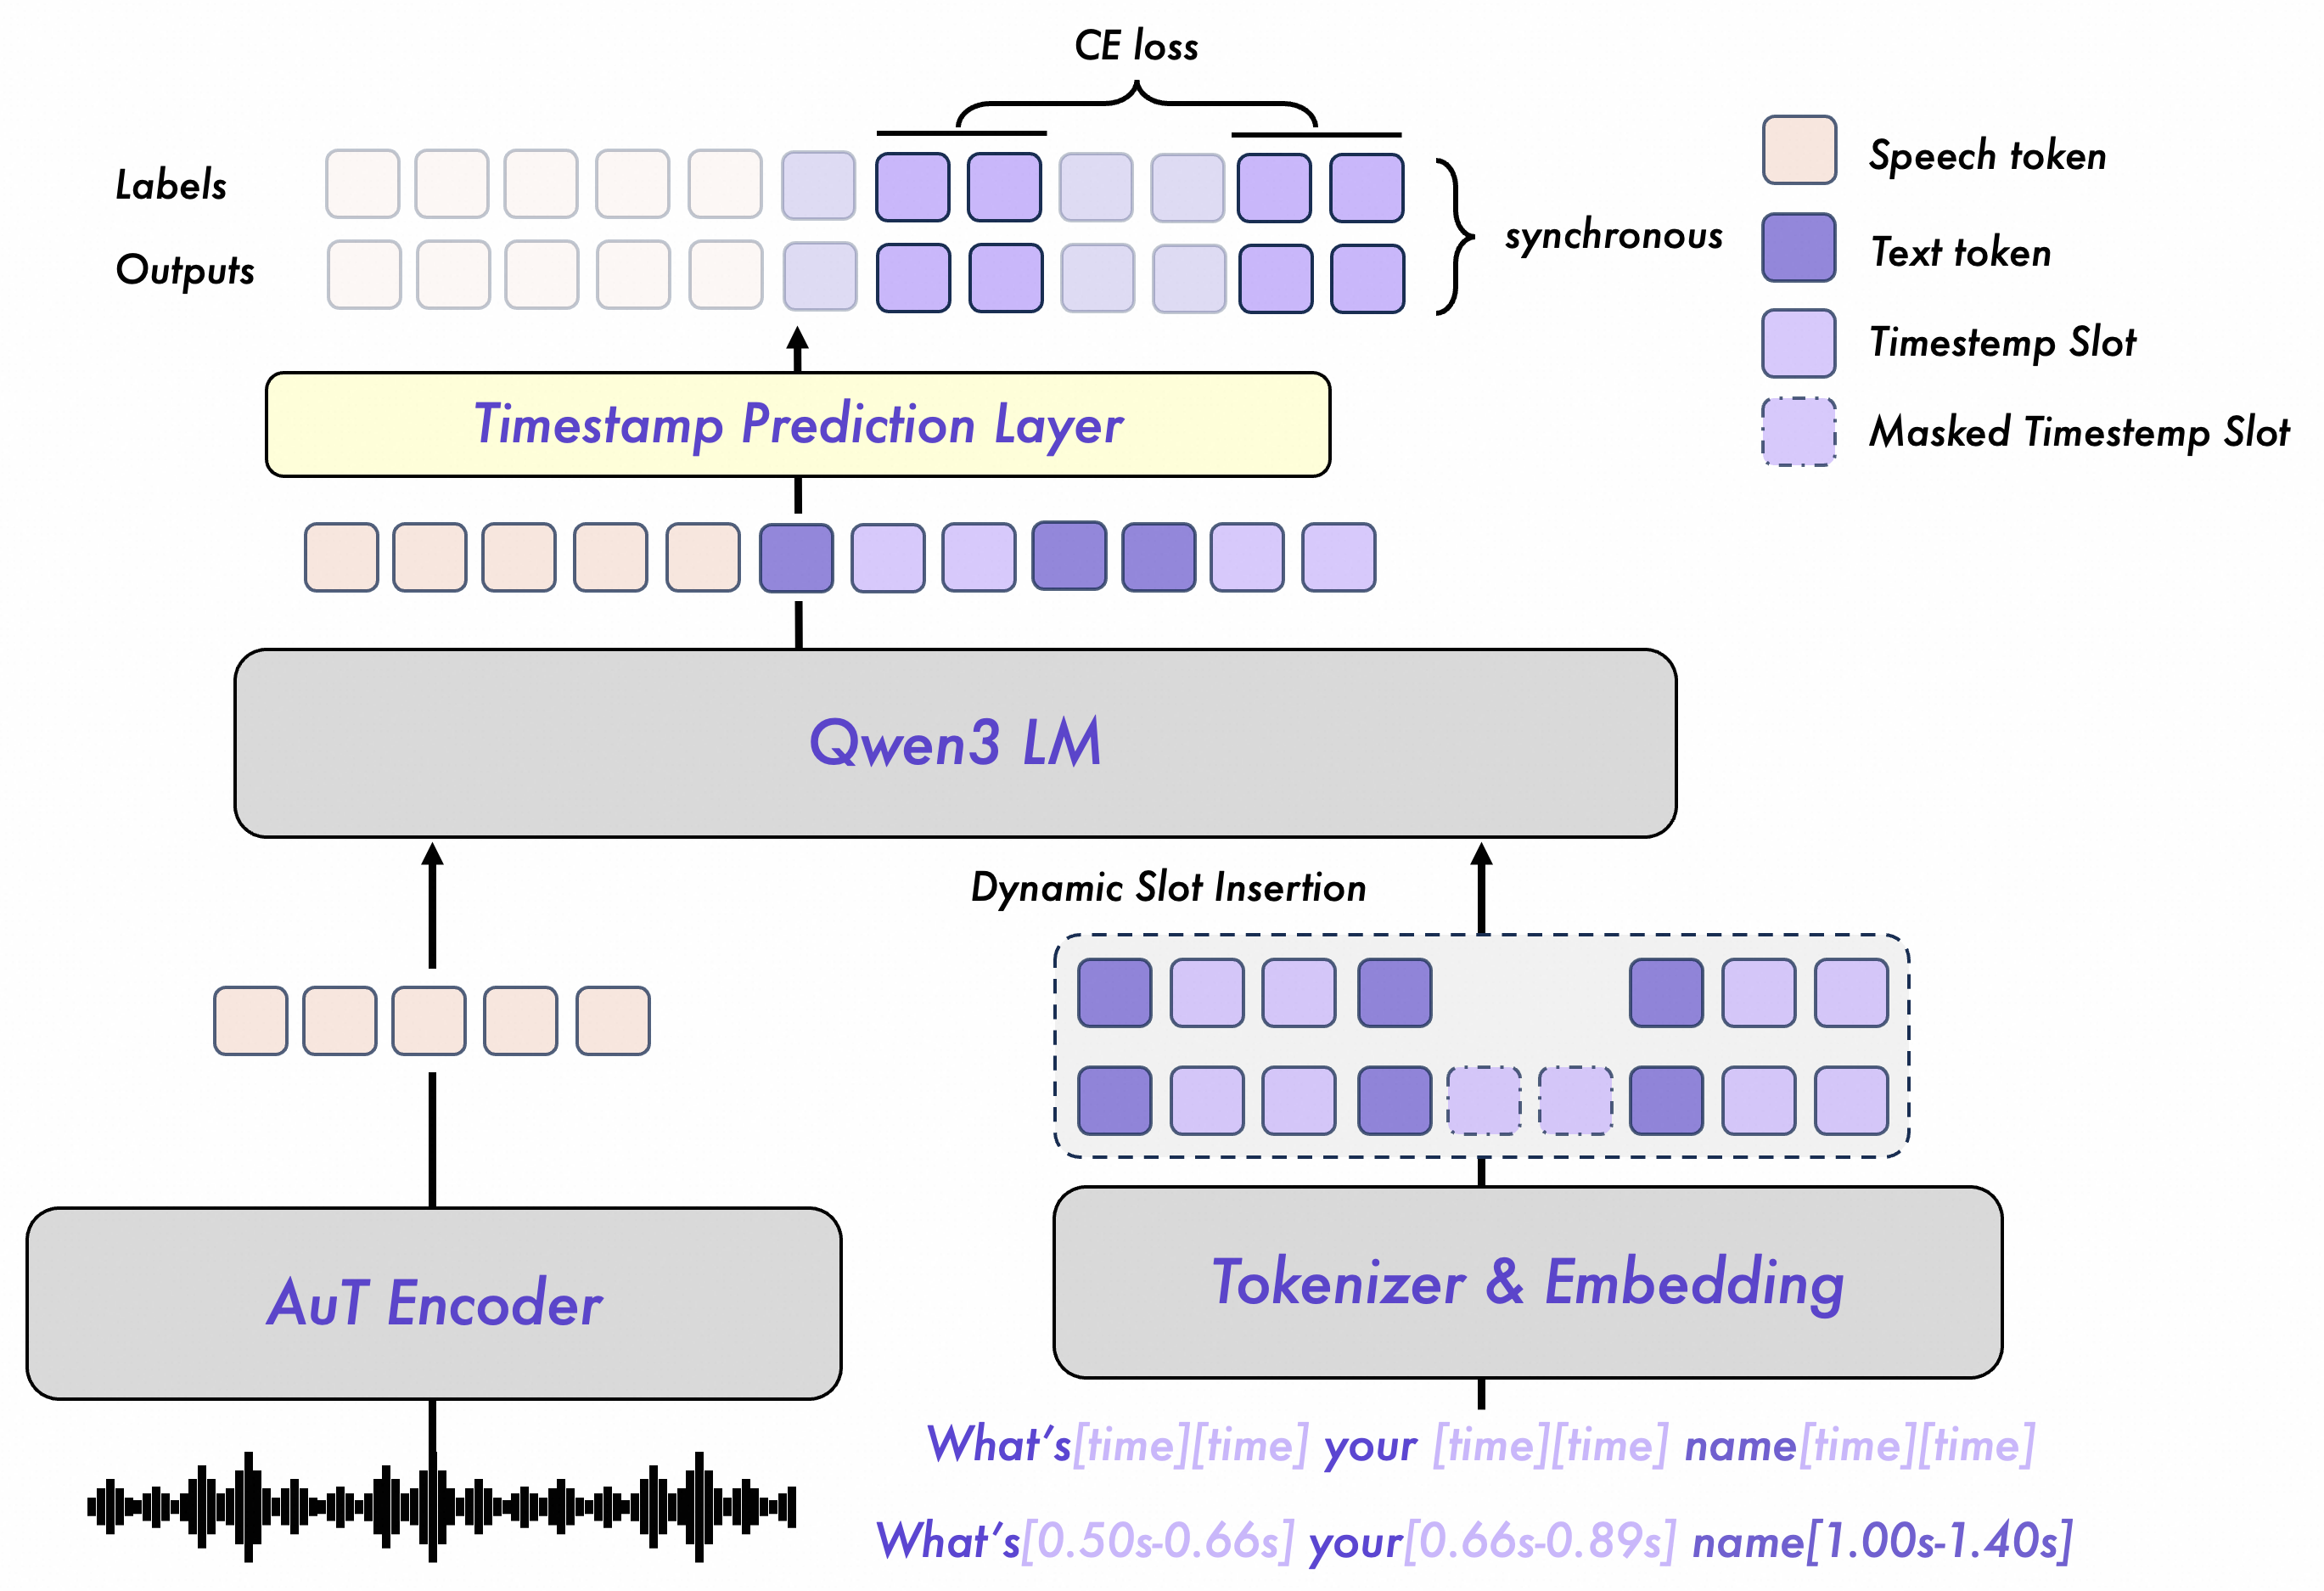
LLM 기반 ASR의 고질적 약점이 타임스탬프 다. 자기회귀 디코더는 프레임과 토큰의 정렬을 명시적으로 갖지 않는다. Qwen3 팀의 답은 별도의 비자기회귀(NAR) 강제 정렬 모델 이다. 전사 텍스트의 단어(또는 문자) 뒤에 [time] 슬롯을 끼워 넣고, AuT 인코더 출력(80ms 프레임)을 기준으로 타임스탬프를 이산 인덱스(최대 3,750 클래스 = 300초) 로 바꾼 뒤, Qwen3-0.6B 위의 선형 레이어가 모든 슬롯의 인덱스를 동시에 예측한다. 추론은 단어, 문장, 문단 등 원하는 단위에 슬롯만 넣으면 되므로 유연하다.
정확도(Table 9, 누적 평균 시프트 AAS, ms, 낮을수록 좋음)는 다음과 같다.
| 테스트셋 | Monotonic-Aligner | NFA | WhisperX | Qwen3-ForcedAligner |
|---|---|---|---|---|
| MFA 레이블 (평균) | 161.1 | 129.8 | 133.2 | 42.9 |
| 사람 레이블 (평균) | 141.3 | 101.2 | – | 32.4 |
기존 정렬기 대비 67~77% 개선 이고, NAR이라 고동시성에서도 RTF 약 0.001을 유지한다. 11개 언어, 최대 5분 길이를 지원한다. 스트리밍에서는 쓸 수 없다는 제약이 있지만, "LLM 디코더 ASR + 별도 NAR 정렬기"라는 분업 구조는 다른 LLM 기반 ASR에도 그대로 적용 가능한 설계로 보인다.
📣 MAI-Transcribe-2-Streaming: 벤더 주장과 독립 측정치
Microsoft 발표문에서 확인되는 내용은 다음이 전부다. 기술 보고서, 아키텍처, 파라미터 수, 학습 데이터는 공개되지 않았으므로 아래는 모두 벤더 주장이다.
- 60개 언어 실시간 전사, 자동·연속 언어 감지
- 오디오를 받은 뒤 "100ms 조금 넘는" 시점에 첫 부분 가설(partial) 을 내고, 컨텍스트가 쌓이면 수정한 뒤 안정된 전사를 바로 확정
- Artificial Analysis에서 final과 partial 모두 정확도 1위, 정확도-지연 Pareto 프런티어 위에 위치
- 실시간 받아쓰기·자막 용도에서 "가장 가까운 경쟁자보다 2배 빠르게 단어가 나타난다" (내부 평가)
- 가격: 올해 말까지 오디오 시간당 $0.54 (도입가)
- 제공 채널: Microsoft Foundry, MAI Playground, Vercel, Azure Voice Live, LiveKit(예정)
"2배 빠르다"는 내부 평가라 검증 불가이고, "100ms 조금 넘는 partial"은 오디오 수신 기준이라 아래 Artificial Analysis의 "발화 종료 이후" 지연과 직접 비교할 수 없다. 반면 리더보드 1위 주장은 독립적으로 확인할 수 있다.
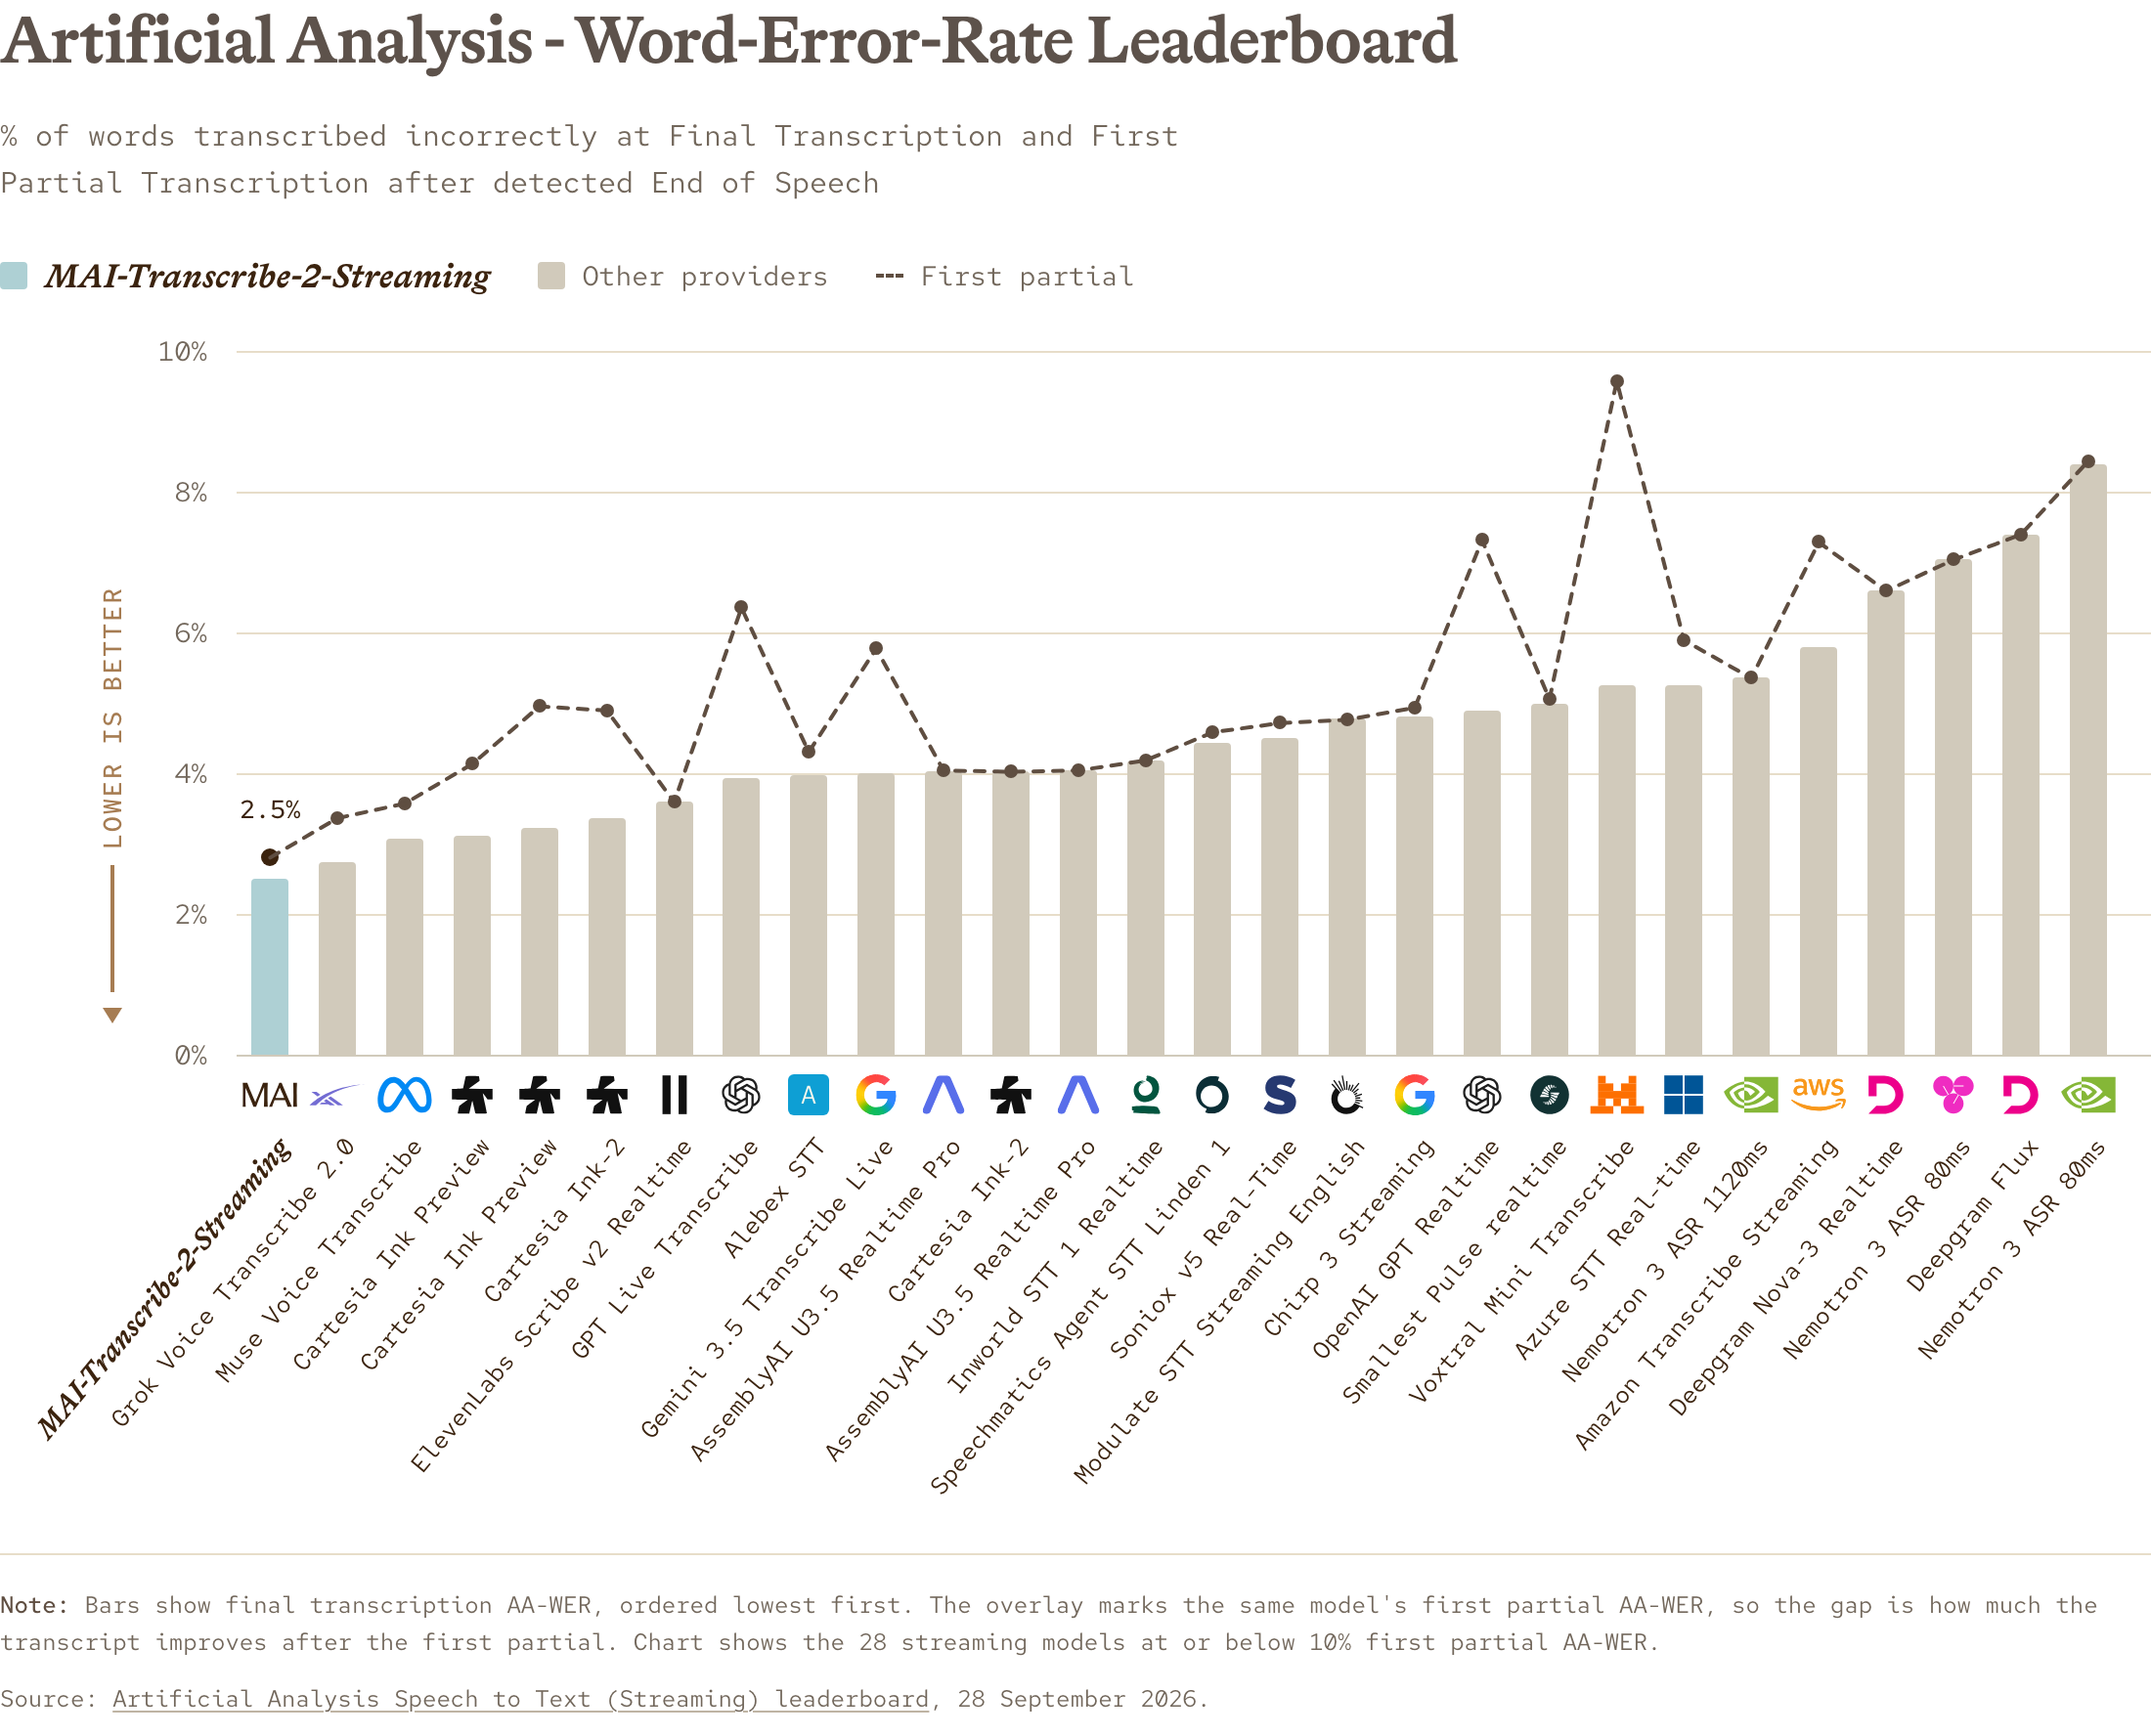
위 차트는 Microsoft가 발표문에 넣은 것이라 Microsoft가 그린 그림 이지만, 출처는 Artificial Analysis(2026년 9월 28일)로 명시돼 있다. 막대(final)와 점선(first partial)의 간격이 "첫 partial 이후 얼마나 고쳐지느냐"인데, MAI는 둘이 거의 같다. 즉 첫 partial이 이미 최종 수준 이라는 뜻이다. 반대로 Gemini 3.5 Transcribe Live, Voxtral Mini Transcribe Realtime, OpenAI GPT Realtime처럼 점선이 막대보다 훨씬 높은 모델은 첫 partial을 많이 고친다.
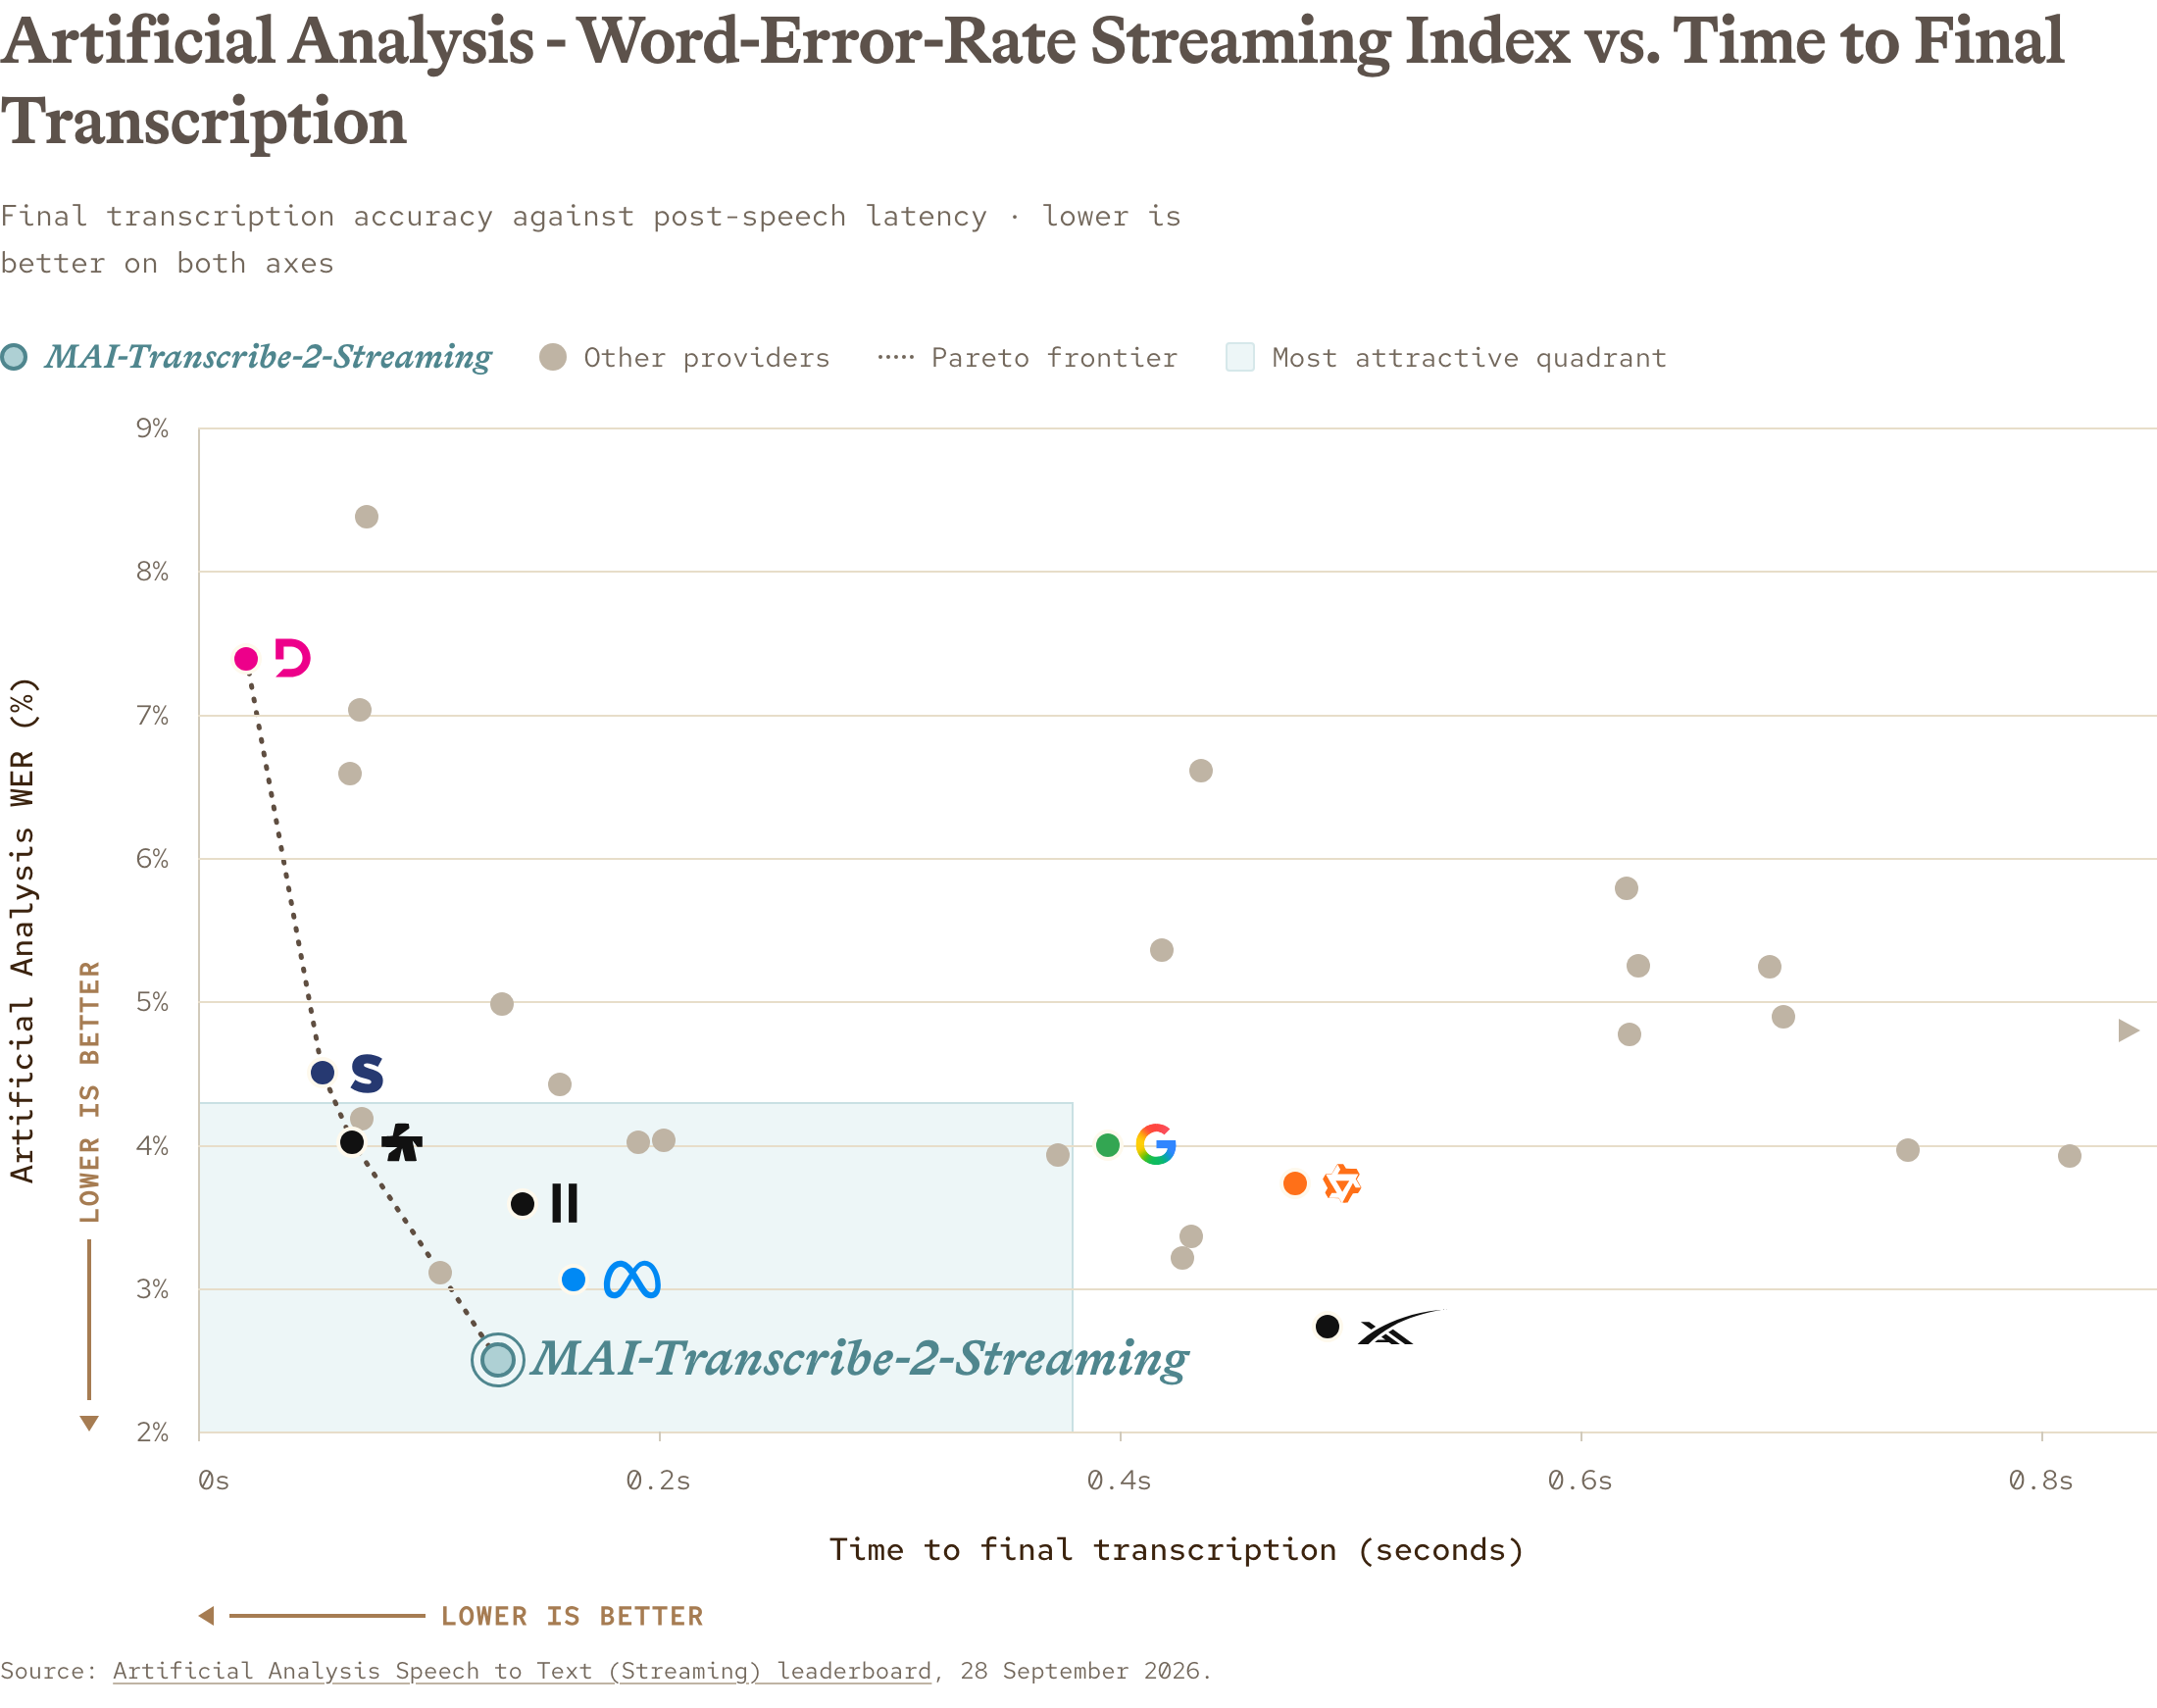
두 번째 차트는 정확도-지연 산점도다. Deepgram Flux(0.02초)처럼 더 빠른 모델은 있지만 정확도가 7%대 이고, Grok Voice Transcribe 2.0처럼 정확도가 비슷한 모델은 지연이 0.49초 다. MAI가 Pareto 프런티어의 꼭짓점에 있다는 벤더 주장은 이 데이터 범위에서는 맞다.
📊 Artificial Analysis 리더보드 직접 확인 (2026-10-08 기준)
벤더 차트가 아니라 리더보드 페이지를 직접 렌더링해 확인했다. AA-WER Streaming 지수는 AA-AgentTalk(50%), VoxPopuli(25%), Earnings22(25%)의 가중 평균이고, 지연은 "발화 종료 후 최종 전사까지의 초"다.
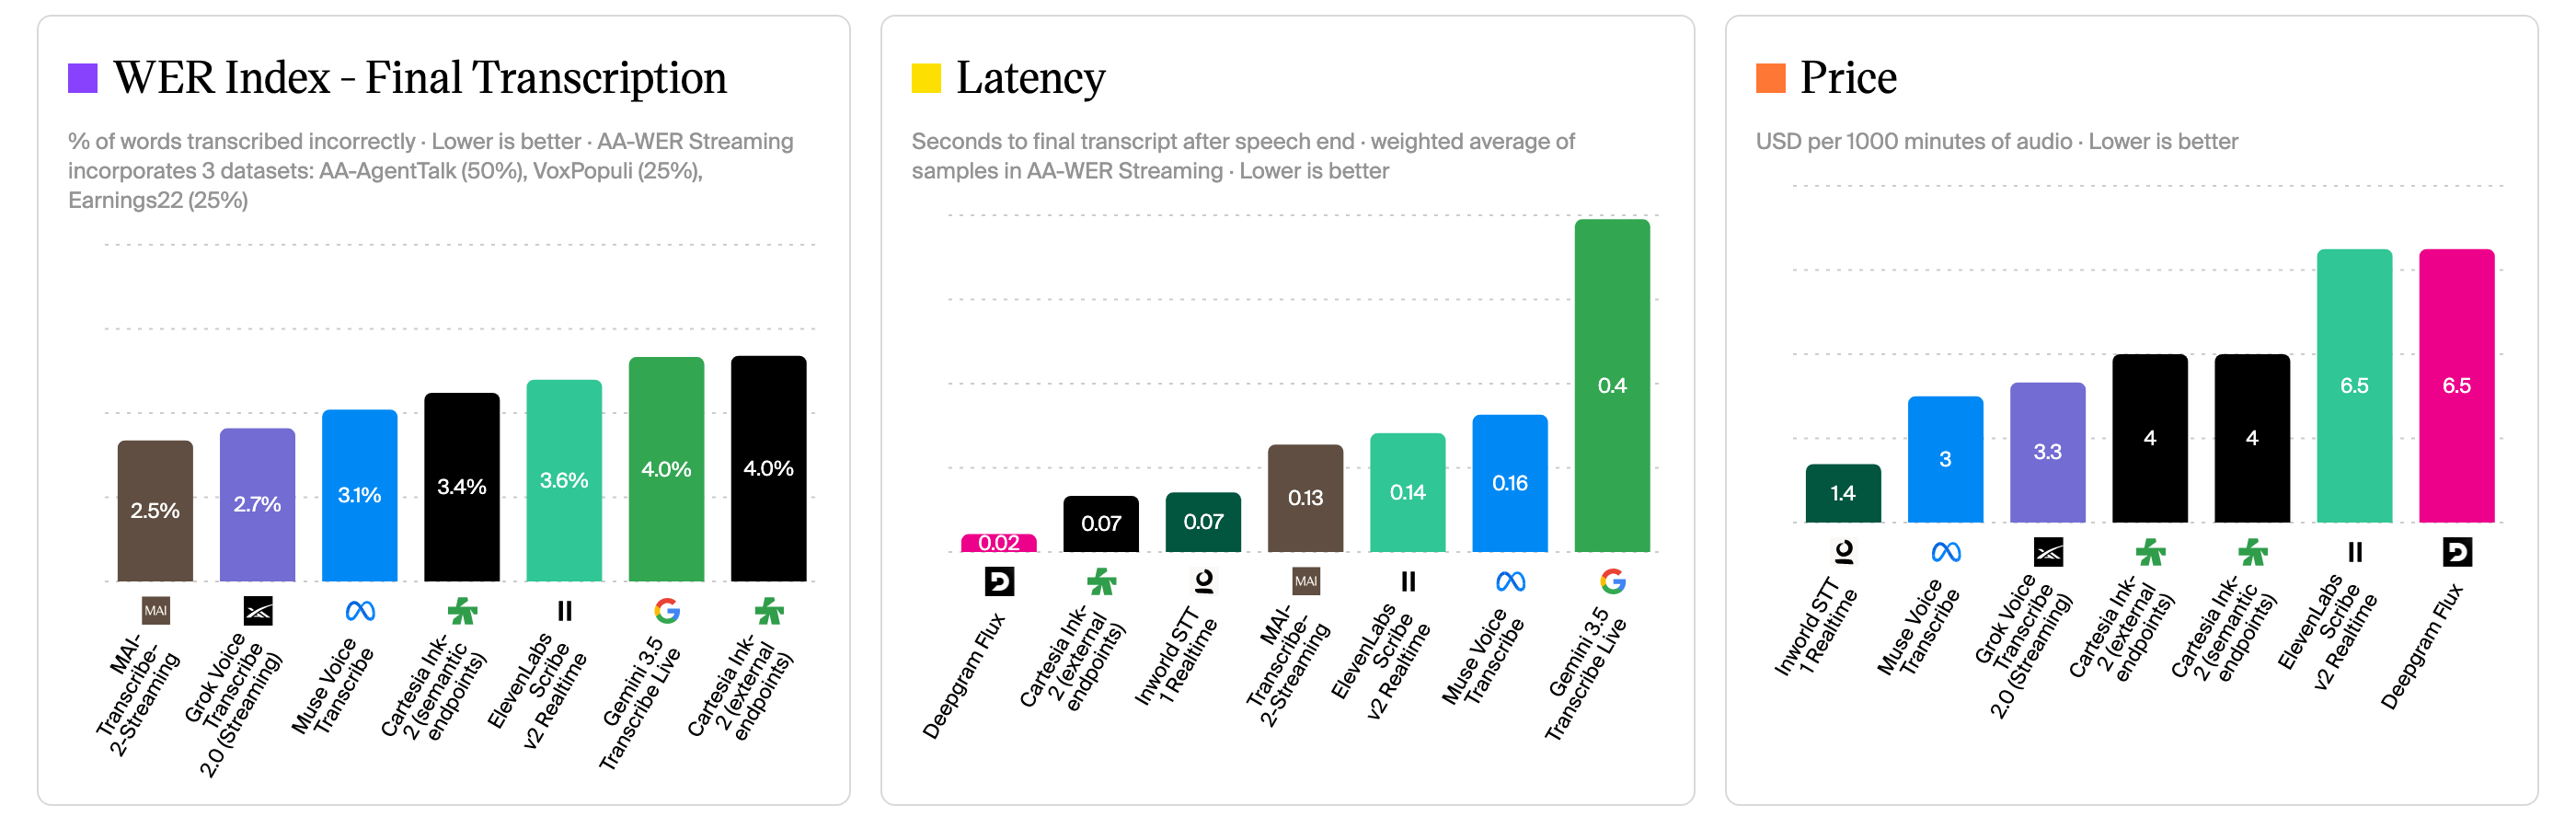
페이지에 내장된 데이터에서 주요 모델을 뽑아 정리하면 다음과 같다(41개 모델 중 발췌).
| 모델 (제공사) | Final WER | First-partial WER | 최종 전사 지연 | 가격 ($/1000분) |
|---|---|---|---|---|
| MAI-Transcribe-2-Streaming (Microsoft AI) | 2.51% | 2.52% | 0.128s | 9 |
| Grok Voice Transcribe 2.0 (SpaceXAI) | 2.73% | 3.36% | 0.490s | 3.33 |
| Muse Voice Transcribe (Meta) | 3.06% | 3.57% | 0.163s | 3 |
| ElevenLabs Scribe v2 Realtime | 3.59% | 3.59% | 0.141s | 6.5 |
| Qwen3 ASR Flash Realtime (Alibaba Cloud API) | 3.73% | 19.94% | 0.476s | 5.4 |
| Gemini 3.5 Transcribe Live (Google) | 4.00% | 5.77% | 0.395s | 9 |
| Soniox v5 Real-Time | 4.50% | 4.71% | 0.054s | 2 |
| Nemotron 3 ASR 1120ms (NVIDIA) | 5.36% | 5.35% | 0.418s | 0 (오픈 가중치) |
| Nemotron 3 ASR 560ms (NVIDIA) | 5.96% | 5.97% | 0.252s | 0 |
| Deepgram Flux | 7.39% | 7.39% | 0.021s | 6.5 |
| Nemotron 3 ASR 160ms (NVIDIA) | 7.61% | 7.63% | 0.098s | 0 |
| Nemotron 3 ASR 80ms (NVIDIA) | 8.38% | 8.43% | 0.073s | 0 |
확인되는 사실은 세 가지다. 첫째, final 2.51%, first-partial 2.52%로 둘 다 1위 라는 Microsoft의 주장은 2026년 10월 8일 기준으로 맞다(partial 2위 Grok 3.36%). 둘째, 데이터셋별로는 AgentTalk 2.27%, VoxPopuli 1.64%, Earnings22 3.88%다. 셋째, 1000분당 $9 = 시간당 $0.54 로 발표 가격과 일치한다. 참고로 같은 사이트의 비스트리밍(배치) 리더보드에는 9월 3일 등록된 MAI-Transcribe-2가 2.0%로 올라 있고, 1위는 StepAudio 3 ASR과 Alibaba의 Fun-Realtime-ASR-preview(각 1.7%)다.
🔁 Nemotron 식 RNN-T 스트리밍과의 비교
같은 리더보드에 NVIDIA의 Nemotron 3 ASR 이 청크 크기별(80/160/560/1120ms)로 네 개 올라 있다. 이 청크 옵션은 이전 글에서 다룬 Nemotron Speech Streaming의 att_context_size 네 단계와 정확히 같다(둘이 같은 모델인지는 리더보드만으로 확인되지 않는다). 흐름은 이전 글의 표와 동일하다. 청크를 1120ms에서 80ms로 줄이면 지연은 0.418초에서 0.073초로 떨어지지만 WER은 5.36%에서 8.38%로 오른다.
반면 MAI-Transcribe-2-Streaming은 0.128초 지연에 2.51%다. 캐시 인식 FastConformer + RNN-T의 "재훈련 없는 지연 조절"이 여전히 유효한 장점이긴 하지만, 적어도 이 벤치마크의 영어 데이터에서는 지연과 정확도 양쪽 모두 상용 LLM 기반(으로 추정되는) 스트리밍 API에 밀린다. 물론 Nemotron은 가격 0, 오픈 가중치, 0.6B급 모델로 자체 GPU에서 돌릴 수 있다는 점이 다르므로 직접 비교는 비용·통제 축을 함께 봐야 한다.
흥미로운 건 Qwen3 ASR Flash Realtime(Alibaba Cloud API) 의 숫자다. final은 3.73%로 준수하지만 first-partial은 19.94% 이고 최종 전사 지연도 0.476초다. 이 API가 오픈소스 Qwen3-ASR-1.7B와 같은 모델인지는 확인되지 않지만, 보고서의 "2초 청크 + 마지막 4개 청크 미확정" 설정이 시사하듯 긴 청크로 정확도를 지키는 대신 partial 품질과 확정 지연을 내주는 전형적인 LLM 디코더 스트리밍의 트레이드오프로 보인다. MAI가 partial과 final을 거의 같게 만든 것이 기술적으로 어떻게 가능한지는, 보고서가 없으니 알 수 없다.
💡 정리, 한계, 열린 질문
정리. 2026년 스트리밍 ASR의 상위권은 "사전학습된 음성 인코더 + 어댑터 + 텍스트 LLM" 구조가 차지하고 있다. 다만 인코더가 Conformer냐 순수 트랜스포머냐는 모델마다 다르고, Qwen3-ASR과 Fun-ASR은 후자다. Qwen3-ASR은 동적 어텐션 윈도로 한 모델이 오프라인·스트리밍을 모두 처리하며, 0.6B 모델이 단일 스트림 TTFT 92ms를 찍는다. MAI-Transcribe-2-Streaming은 구조 비공개지만 독립 리더보드에서 final·partial 모두 1위이고, 시간당 $0.54라는 가격은 발표와 일치한다.
한계. Artificial Analysis 지표는 영어 3개 데이터셋 가중 평균이다. Qwen3-ASR이 강점을 보이는 중국어·방언·노래·극한 잡음은 여기에 없다. 반대로 Qwen3-ASR 보고서의 API 비교는 저자들이 직접 돌린 결과라 평가 시점·설정에 따라 달라질 수 있다. 그리고 Microsoft 쪽은 "100ms partial", "2배 빠름", "60개 언어 품질" 모두 벤더 주장 그대로다.
열린 질문. (1) LLM 디코더 스트리밍에서 partial과 final의 격차를 어떻게 줄이는가. Qwen3-ASR 같은 오픈 모델이 "마지막 N개 청크 미확정" 외의 기법을 공개할지 궁금하다. (2) 동시성이 오르면 TTFT가 수 초까지 늘어나는 Qwen3-ASR의 Table 2 수치는 서빙 비용의 현실을 보여준다. 상용 API들이 어떤 동시성에서 측정됐는지는 리더보드에 없다. (3) 타임스탬프는 여전히 별도 모델(Qwen3-ForcedAligner, FireRedASR2-AED의 CTC 브랜치)의 몫이다. 스트리밍 중 타임스탬프까지 내는 LLM 기반 ASR은 아직 보이지 않는다.
📚 참고
- Microsoft AI, Our first streaming transcription model debuts at no. 1 on Artificial Analysis (2026-10-01)
- Qwen Team, Qwen3-ASR Technical Report (arXiv:2601.21337, 2026-01) · GitHub QwenLM/Qwen3-ASR · HF Qwen/Qwen3-ASR-1.7B
- Artificial Analysis, Speech to Text Leaderboard (Streaming) · (Non-streaming) — 2026-10-08 확인
- Tongyi Fun Team (Alibaba), Fun-ASR Technical Report (arXiv:2509.12508)
- FireRed Team, FireRedASR2S (arXiv:2603.10420) · FireRedASR (arXiv:2501.14350)
- NVIDIA, canary-qwen-2.5b 모델 카드
- Qwen Team, Qwen3-Omni Technical Report (AuT 인코더 설명)
- 이 블로그: NVIDIA Nemotron Speech Streaming ASR · Meta Omnilingual ASR
본 글의 그림은 원문에서 가져왔습니다. (그림 3·4는 Microsoft 발표문에 포함된 Artificial Analysis 데이터 차트, 그림 5는 Artificial Analysis 리더보드 페이지 캡처입니다.)